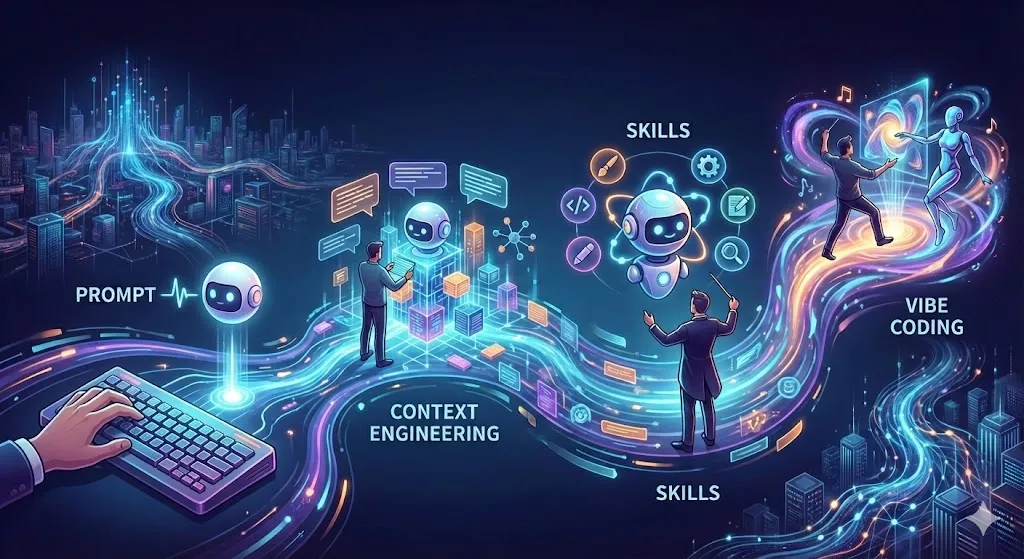
從 Prompt 到上下文工程到 Skills:AI 互動正規化的演進與 Vibe Coding 的崛起
引言:AI 互動的三次革命
2022 年底,ChatGPT 的橫空出世標誌著人工智慧進入了一個全新的時代。短短兩年多時間,我們與 AI 的互動方式已經經歷了三次深刻的正規化轉變:
第一次革命:Prompt Engineering(提示工程) —— 我們學會了如何與 AI 對話,用精心設計的提示詞來引導模型輸出。
第二次革命:Context Engineering(上下文工程) —— 我們意識到 AI 的能力不僅取決於提示詞本身,更取決於提供給它的上下文環境。RAG、記憶系統、外部知識庫的引入,讓 AI 從”閉卷考試”變成了”開卷考試”。
第三次革命:Skills & Agentic AI(技能與智慧體) —— AI 不再只是被動回答問題,而是能夠主動呼叫工具、執行動作、與其他 Agent 協作,成為真正的”數字工作者”。
與此同時,一種全新的程式設計正規化正在悄然興起 —— Vibe Coding(氛圍程式設計),它正在重新定義人類與 AI 在軟體開發中的協作關係。
本文將帶你完整走過這段演進歷程,無論你是剛接觸 AI 的初學者,還是希望深入理解底層邏輯的技術從業者,都能從中獲得系統性的認知提升。
第一章:Prompt Engineering —— 與 AI 對話的藝術
1.1 什麼是 Prompt Engineering?
Prompt Engineering(提示工程)是指透過設計和最佳化輸入提示(prompt),來引導大型語言模型(LLM)產生更準確、更有用輸出的技術。它是最基礎、最直觀的 AI 互動方式 —— 你輸入文字,AI 返回文字。
但Prompt Engineering 遠不止是”問問題”這麼簡單。正如 2025 年的最佳實踐所強調的:“Specific prompts are better prompts”(具體的提示才是好提示)。
一個糟糕的例子:
"解释气候变化"一個優秀的例子:
"为高中生撰写一段关于气候变化的三段式总结,使用项目符号,
保持中立语气,控制在 300 字以内。"
1.2 核心技術技法
Zero-Shot Prompting(零樣本提示)
直接向模型提出任務,不提供任何示例。這是最簡單的方式,適用於模型已經具備相關知識的任務。
将以下英文翻译成中文:
"The quick brown fox jumps over the lazy dog."
Few-Shot Prompting(少樣本提示)
提供 3-5 個高質量的示例,讓模型學習模式和格式。研究表明,這是提升輸出質量最有效的方法之一。
将情感分类为正面、负面或中性。

示例 1:
文本:"这部电影太棒了!"
情感:正面

示例 2:
文本:"服务态度很差"
情感:负面

示例 3:
文本:"今天天气晴朗"
情感:中性

待分类文本:"这个产品完全不符合预期"
情感:
Chain-of-Thought (CoT) 思維鏈
要求模型展示推理過程,而非直接給出答案。這對數學問題、邏輯推理尤其有效。
问题:一个农场有 35 只鸡和 28 只兔子。农场主卖掉了一半的鸡和
三分之一的兔子。还剩多少只动物?

请一步一步思考:
模型會輸出:
1. 初始鸡的数量:35 只
2. 卖掉一半的鸡:35 ÷ 2 = 17.5,取整为 17 只
3. 剩余鸡:35 - 17 = 18 只
4. 初始兔子数量:28 只
5. 卖掉三分之一的兔子:28 ÷ 3 ≈ 9 只
6. 剩余兔子:28 - 9 = 19 只
7. 总共剩余:18 + 19 = 37 只
ReAct (Reasoning + Acting) 推理+行動
結合推理和工具呼叫的先進技法。模型不僅思考,還能決定何時使用外部工具。
你需要搜索最新信息来回答用户问题。

问题:苹果公司今天的股价是多少?

思考:我需要搜索苹果的最新股价
行动:搜索 "Apple stock price today"
观察:[搜索结果:AAPL $182.50, +1.2%]
思考:我已经获得了股价信息
最终答案:苹果公司今天股价为 182.50 美元,上涨 1.2%
1.3 2025 年的前沿技術
Recursive Self-Improvement Prompting (RSIP) 遞迴自改進提示
讓 AI 批判並改進自己的輸出,透過多輪迭代達到更高質量。
流程:
- 生成:建立初始輸出
- 批判性評估:讓模型使用特定標準識別弱點
- 改進:基於批評生成增強版本
實踐表明,這種方法可以減少約 60% 的修改週期。
Multi-Perspective Simulation (MPS) 多視角模擬
在單次對話中執行”虛擬專家小組”,讓模型從不同角度分析問題。
请从以下三个角度分析这个商业决策:
1. 财务总监(关注成本与 ROI)
2. 技术总监(关注可行性与技术债务)
3. 市场总监(关注用户体验与竞争优势)

每个视角都需要:
- 阐述核心观点
- 提出潜在风险
- 给出具体建议

最后,请综合三个视角给出整体评估。
1.4 Prompt Engineering 的侷限性
儘管 Prompt Engineering 強大,但它存在根本性限制:
-
Fragility(脆弱性):輸入的微小變化、系統版本更新,甚至模型的隨機性,都可能導致輸出質量波動
-
Limited Context(上下文限制):模型的上下文視窗有限,無法處理大量外部資訊
-
No Real-Time Knowledge(無實時知識):模型只能依賴訓練資料,無法獲取最新資訊
-
No Action Capability(無行動能力):模型只能生成文字,無法執行實際操作
這些限制催生了下一個演進階段 —— Context Engineering。
第二章:Context Engineering —— 構建 AI 的操作環境
2.1 從 Prompt 到 Context 的正規化轉移
Context Engineering(上下文工程)是 2024-2025 年興起的新 discipline。如果說 Prompt Engineering 是”寫好問題”,Context Engineering 就是”構建完整的操作環境”。
核心定義:
Context Engineering 是系統地設計和管理提供給 LLM 的所有資訊 —— 包括提示、檢索結果、對話歷史、後設資料、工具狀態 —— 以控制模型的推理和輸出,而無需修改模型權重。
簡單來說,Context Engineering = Prompt Engineering + RAG + 記憶管理 + 工具狀態 + 環境配置
2.2 RAG:檢索增強生成
RAG(Retrieval-Augmented Generation)是 Context Engineering 的核心元件。它解決了 LLM 無法訪問私有資料、無法獲取實時資訊的問題。
RAG 工作流程:
用户查询 → 嵌入向量 → 向量数据库检索 → 获取 Top-K 相关文档
→ 将文档注入提示上下文 → LLM 生成回答
實際應用場景:
場景 1:企業知識庫問答
基于以下公司内部文档回答问题:
<documents>
[从向量数据库检索的相关文档片段]
</documents>

问题:我们的年假政策是什么?
请引用相关文档的具体章节并标注页码。
場景 2:客服機器人
你是一个客服助手。以下是相关的产品文档和历史对话:
<context>
[产品手册片段]
[用户之前的工单记录]
[常见问题解答]
</context>

用户问题:我的订单什么时候能到?
订单号:#12345
2.3 上下文工程的技術支柱
1. Prompt Design(提示設計)
動態提示模板,根據使用者、任務和系統狀態組裝不同的提示。
# 动态提示模板示例
def build_prompt(user_type, task, context):
    system_prompt = f"你是一个{user_type}专家助手。"
    user_prompt = f"任务:{task}\n\n上下文:{context}"
    return system_prompt + user_prompt
2. Context Composition(上下文組合)
現代 AI 系統需要組合多層上下文:
- 對話歷史:保持對話連貫性
- 檢索結果:外部知識注入
- 當前工具狀態:告訴 AI 有哪些工具可用
- Agent 目標與計劃:長期任務的狀態跟蹤
- 使用者畫像/偏好:個性化設定
context_stack = {
    "system_instructions": "你是一个研究助手...",
    "user_profile": {"role": "研究员", "expertise": "AI"},
    "conversation_history": [...],
    "retrieved_documents": [...],
    "available_tools": ["search", "calculator", "code_runner"],
    "current_task_state": {"step": 3, "goal": "完成报告"}
}
3. Memory Systems(記憶系統)
生產級 Agent 需要四層記憶架構:
| 記憶型別 | 描述 | 技術實現 |
|---|---|---|
| Short-Term Memory (STM) | 當前對話的短期上下文 | 滑動視窗,保留最近 N 輪對話 |
| Working Memory | 當前任務的臨時狀態 | 變數儲存,任務完成即清除 |
| Long-Term Memory (LTM) | 使用者偏好、歷史互動 | 向量資料庫持久化儲存 |
| Episodic Memory | 特定事件/經驗的記憶 | 結構化儲存,支援語義檢索 |
2.4 Prompt Engineering vs Context Engineering
| 維度 | Prompt Engineering | Context Engineering |
|---|---|---|
| 關注點 | 提示詞的措辭和結構 | 完整的輸入環境設計 |
| 範圍 | 單次互動 | 多輪對話 + 外部系統 |
| 技術棧 | 自然語言 + 模板 | RAG + 向量DB + 記憶系統 |
| 目標 | 最佳化單次輸出 | 塑造持續可靠的行為 |
| 適用場景 | 簡單問答、內容生成 | 複雜應用、生產系統 |
關鍵洞察:
“Prompt Engineering 最佳化即時輸出,Context Engineering 治理模型在推理前看到的所有上下文,塑造生產系統中的持續行為。”
第三章:Skills、Tool Use 與 Agentic AI —— 從說話到行動
3.1 工具呼叫:AI 的”手”和”腳”
如果說 Context Engineering 給了 AI “眼睛”(看外部資訊),那麼 Tool Use(工具呼叫)就給了 AI “手”和”腳”(執行動作)。
Tool Calling 的定義:
工具呼叫是 LLM 決定使用外部功能(執行程式碼、呼叫 API、搜尋網頁、運算元據庫)來完成模型自身無法獨立完成的任務的過程。
工具呼叫的決策流程:
1. 解析用户查询 → 理解用户想要什么
2. 映射意图到工具模式 → 对比可用工具描述
3. 决定是否需要工具 → 纯推理 vs 需要执行
4. 生成结构化工具调用 → JSON 格式的函数调用
5. 在外部执行工具 → Python/API/数据库查询
6. 将输出返回给 LLM → 工具执行结果
7. LLM 决定下一步 → 继续调用工具或直接回答
3.2 Function Calling 實戰示例
示例:天氣查詢 Agent
首先,定義工具的模式(Schema):
{
  "name": "get_weather",
  "description": "获取指定城市的当前天气",
  "parameters": {
    "type": "object",
    "properties": {
      "city": {
        "type": "string",
        "description": "城市名称,如 '北京'、'上海'"
      },
      "unit": {
        "type": "string",
        "enum": ["celsius", "fahrenheit"],
        "description": "温度单位"
      }
    },
    "required": ["city"]
  }
}
使用者輸入:“北京今天天氣怎麼樣?”
LLM 的決策過程:
思考:用户询问北京天气,我需要调用 get_weather 工具
工具调用:{"tool": "get_weather", "arguments": {"city": "北京", "unit": "celsius"}}
後端執行工具,返回:
{
  "temperature": 22,
  "condition": "晴朗",
  "humidity": "45%"
}
LLM 生成最終回答:
北京今天天气晴朗,气温 22°C,湿度 45%,是个出行的好天气!3.3 MCP:模型上下文協議 —— AI 的”USB-C”
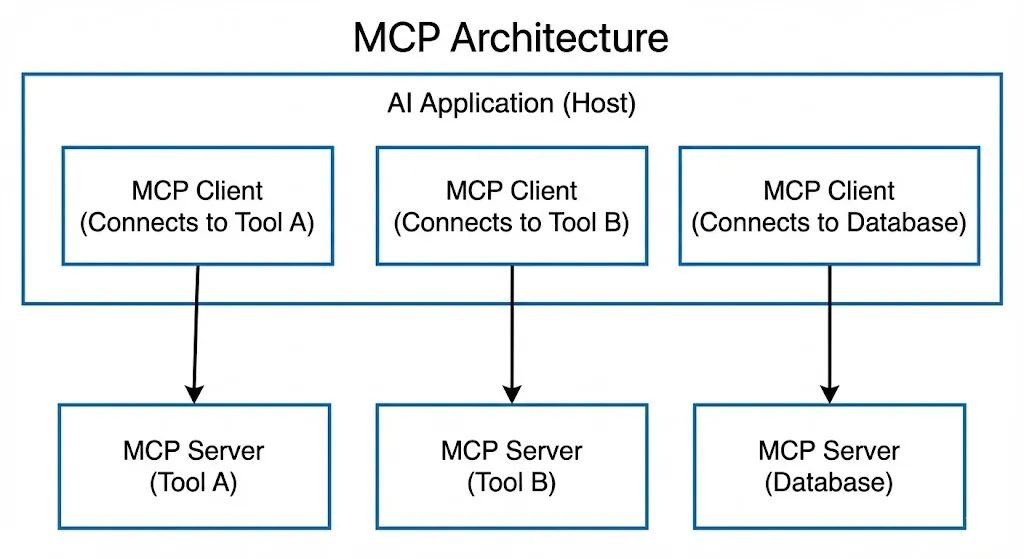
2024 年底,Anthropic 推出了 MCP(Model Context Protocol),這是一個開放標準協議,旨在標準化 AI 系統與外部工具和資料來源的互動方式。
MCP 的核心願景:
“就像 USB-C 為各種裝置提供通用連線一樣,MCP 為 AI 模型提供統一的介面來連線不同的工具和資料來源。”
MCP 架構:
MCP 2025 年路線圖包括:
- 遠端 MCP 連線:支援 OAuth 2.0 認證與授權
- 分發與發現:包管理、安裝工具、伺服器註冊
- Agent 支援:分層 Agent 系統、互動式工作流、流式結果
MCP 正在快速成為行業標準,類似於當年的 LSP(Language Server Protocol)。
3.4 A2A:Agent-to-Agent 協議 —— AI 的”社交語言”
如果說 MCP 是 AI 與工具的通用介面,那麼 A2A(Agent-to-Agent Protocol) 就是 AI 與 AI 之間的通用語言。
2025 年 4 月,Google 推出了 A2A 協議,這是一個開放標準,旨在讓不同框架、不同廠商的 AI Agent 能夠發現彼此、協商任務、協作完成複雜工作流。
A2A 的五大設計原則:
- 擁抱自然 Agent 能力:不強制改變 Agent 的工作方式
- 基於現有標準:使用 HTTP、JSON-RPC 等成熟技術
- 企業級安全:內建認證、授權、加密
- 支援長時間任務:非同步執行、狀態更新、推送通知
- 模態無關:支援文字、音訊、影片、結構化資料
A2A 的核心概念:
| 元件 | 描述 |
|---|---|
| Agent Cards | JSON 後設資料檔案,描述 Agent 的能力、身份、端點 |
| Task Management | 任務生命週期管理:發起、狀態更新、完成通知 |
| Collaboration | Agent 間交換上下文、協商執行方式 |
| UX Negotiation | 協商內容型別和格式,適應不同 UI 能力 |
實際應用場景:
招聘流程自動化:
招聘经理 Agent → 发布招聘需求
       ↓
猎头 Agent A → 搜索候选人
       ↓
猎头 Agent B → 安排面试
       ↓
背景调查 Agent → 执行背景核查
       ↓
所有结果汇总 → 招聘经理 Agent
每個 Agent 可能來自不同廠商、使用不同框架,但透過 A2A 協議可以無縫協作。
3.5 現代 Agent 架構
一個生產級的 AI Agent 可以形式化定義為:
Agent := <Perception, Memory, Reasoning, Planning, Action, Feedback>各元件詳解:
| 元件 | 功能 | 技術實現 |
|---|---|---|
| Perception | 接收輸入 | 文字解析、API 介面卡、日誌讀取 |
| Memory | 儲存狀態 | 向量 DB、文件儲存、短期上下文 |
| Reasoning | 推理決策 | LLM 推理 + CoT/ReAct/ToT |
| Planning | 任務規劃 | 任務分解、工具選擇、執行圖 |
| Action | 執行動作 | 工具呼叫、API 請求、程式碼執行 |
| Feedback | 反饋學習 | 錯誤分析、自我批評、記憶更新 |
2025 年的 Agent 型別:
- Deep Research Agents:自主進行深度研究,如 Perplexity、Grok
- Coding Agents:Devin、Cursor IDE Agents,自主編寫、除錯、測試程式碼
- CUA (Computer-Using Agents):模擬人類操作電腦介面,如 AutoGPT、SIMA
- Multi-Agent Systems:多個專業 Agent 協作,如 CrewAI、AutoGen
第四章:Vibe Coding —— 程式設計正規化的顛覆
4.1 什麼是 Vibe Coding?
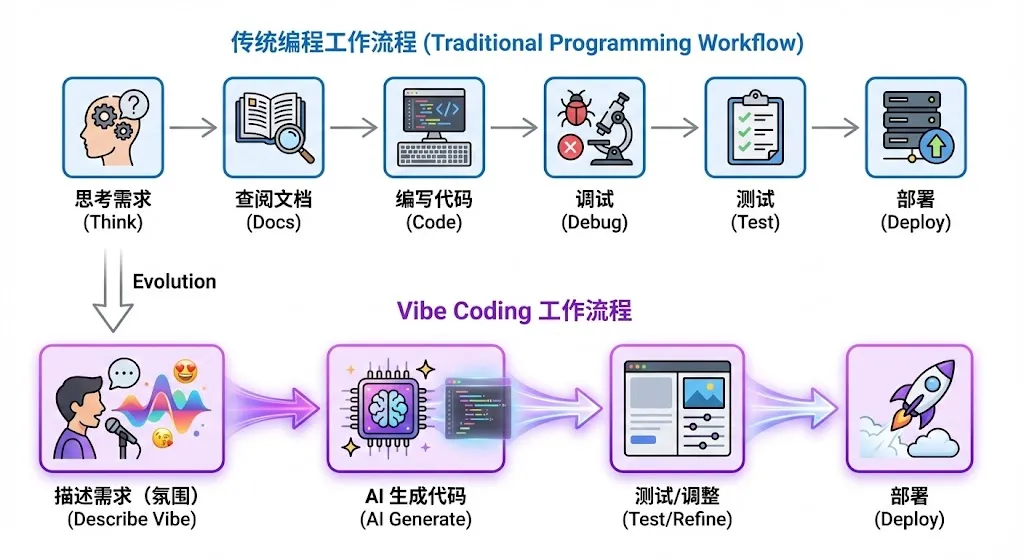
Vibe Coding 是 2024-2025 年興起的一種全新程式設計正規化。它不關注程式碼的具體語法,而是關注”氛圍”——開發者用自然語言描述想要的功能和感覺,AI 負責生成具體的程式碼實現。
核心定義:
Vibe Coding 是一種開發方法,開發者使用自然語言提示 AI 工具生成軟體程式碼。它將重點從手動編碼轉移到 AI 引導的構建方式。
Vibe Coding 的工作流程:
4.2 Vibe Coding 的起源與演進
2023 年:Reddit 上的開發者開玩笑說他們在用 ChatGPT “vibe” 功能到現實中 —— 這只是一個梗。
2024 年底:OpenAI 創始成員 Andrej Karpathy 認真對待這個概念,稱之為”AI 原生開發的下一個演進”。
2025 年初:《華爾街日報》確認企業開始在實際開發工作流中採用 Vibe Coding。
今天:Vibe Coding 已經從梗變成了嚴肅的方法論。
4.3 Vibe Coding 的工具生態
| 工具 | 特點 | 適用場景 |
|---|---|---|
| Cursor | AI 原生程式碼編輯器,對話式開發 | 專業開發,複雜專案 |
| GitHub Copilot X | IDE 內實時程式碼建議 | 日常編碼,快速補全 |
| Replit Ghostwriter | 瀏覽器內多模態構建 | 快速原型,教育 |
| Claude 3/4 | 長上下文理解 | 複雜邏輯,程式碼審查 |
| ChatGPT-4/4.5 | 自然語言優先 | 快速原型,學習 |
4.4 Vibe Coding 實戰示例
場景:建立一個待辦事項應用
傳統方式:
// 需要手动编写所有代码
import React, { useState } from 'react';

function TodoApp() {
  const [todos, setTodos] = useState([]);
  const [input, setInput] = useState('');

  const addTodo = () => {
    if (input.trim()) {
      setTodos([...todos, { id: Date.now(), text: input, done: false }]);
      setInput('');
    }
  };

  // ... 还需要写 toggle、delete、filter 等功能

  return (
    // ... JSX 代码
  );
}
Vibe Coding 方式:
用户:"创建一个漂亮的待办事项应用,要有:
- 添加任务的功能
- 标记完成/未完成
- 删除任务
- 按状态筛选(全部/进行中/已完成)
- 使用现代简洁的设计风格
- 数据保存在 localStorage"

AI:(生成完整可运行的代码)

用户:"把完成任务的动画做得更流畅一些,
再加一个进度统计在顶部"

AI:(更新代码)
4.5 Vibe Coding 的核心理念
- 設計優先,快速原型:先描述想要的感覺和體驗,再迭代細節
- 對話式除錯:用自然語言問”為什麼這個會失敗?“而不是查文件一小時
- 關注產品而非語法:把精力集中在使用者體驗和業務邏輯上
- 迭代速度至上:快速實驗,快速驗證,快速調整
4.6 Vibe Coding 的優勢與風險
優勢:
- ✅ 極大提升開發速度(10倍加速在 build-test 週期)
- ✅ 降低程式設計門檻,非技術人員也能構建原型
- ✅ 減少樣板程式碼的編寫
- ✅ 加速學習和實驗
風險與爭議:
- ⚠️ 安全漏洞:AI 生成的程式碼可能存在安全隱患,需要人工審查
- ⚠️ 技術債務:快速生成的程式碼可能缺乏長期可維護性
- ⚠️ 理解深度:開發者可能不完全理解 AI 生成的程式碼
- ⚠️ 除錯困難:當 AI 生成的程式碼出錯時,定位問題可能更困難
最佳實踐:
“Vibe Coding 不是完全替代傳統開發,而是改變開發者的角色 —— 從逐行編寫程式碼,轉變為指導、測試和最佳化 AI 生成的輸出。開發者成為 AI 的導師,確保生成的程式碼符合專案需求和最佳實踐。”
第五章:整合與展望 —— 四層架構的統一檢視
5.1 四個層次的演進關係
┌─────────────────────────────────────────────────────────────────┐
│                    第四层:Vibe Coding                           │
│              (人类与 AI 协作的最高形态)                          │
│         开发者描述意图 → AI 生成完整应用 → 迭代优化               │
├─────────────────────────────────────────────────────────────────┤
│                    第三层:Skills & Agentic AI                   │
│              (AI 的行动能力和协作能力)                           │
│    MCP(工具连接) + A2A(Agent 协作) + Function Calling        │
├─────────────────────────────────────────────────────────────────┤
│                    第二层:Context Engineering                   │
│              (AI 的知识环境和记忆系统)                           │
│         RAG + 记忆管理 + 上下文组合 + 外部数据注入                │
├─────────────────────────────────────────────────────────────────┤
│                    第一层:Prompt Engineering                    │
│              (与 AI 对话的基础能力)                              │
│         Zero/Few-Shot + CoT + ReAct + 结构化输出                │
└─────────────────────────────────────────────────────────────────┘
5.2 各層之間的依賴關係
- Prompt Engineering 是基礎:所有上層都依賴於如何有效地與模型溝通
- Context Engineering 是增強:讓模型能夠訪問更多資訊和知識
- Skills/Agentic AI 是躍遷:讓模型從”說話”到”行動”
- Vibe Coding 是融合:重新定義人類在 AI 時代的角色
5.3 2025-2026 年的關鍵趨勢
趨勢 1:協議標準化
MCP 和 A2A 正在快速成為行業標準,類似於:
- MCP ≈ USB-C:統一 AI 與工具的連線方式
- A2A ≈ HTTP:統一 AI 與 AI 的通訊方式
趨勢 2:Agent 經濟崛起
據 2025 年全球 AI 調查:
- 29% 的企業已經在生產環境執行 Agentic AI
- 44% 計劃在未來一年內加入
- 88% 的早期採用者報告了正向 ROI
趨勢 3:開發者角色轉型
開發者的工作正在從:
编写代码 → 架构设计 + AI 协作 + 代码审查趨勢 4:多 Agent 協作成為常態
複雜任務將由多個專業 Agent 協作完成:
- 研究 Agent + 寫作 Agent + 審查 Agent
- 前端 Agent + 後端 Agent + 測試 Agent
- 資料分析 Agent + 視覺化 Agent + 報告 Agent
5.4 給初學者的學習路徑
階段 1:掌握 Prompt Engineering(1-2 周)
- 學習 Zero/Few-Shot、CoT、ReAct 等基礎技術
- 練習編寫清晰、具體的提示
- 理解模型的能力和侷限性
階段 2:理解 Context Engineering(2-3 周)
- 學習 RAG 原理和實現
- 瞭解向量資料庫(Pinecone、Weaviate、Chroma)
- 實踐構建有記憶的對話系統
階段 3:探索 Tool Use & Agents(3-4 周)
- 學習 Function Calling
- 瞭解 MCP 協議
- 嘗試構建簡單的 Agent
階段 4:實踐 Vibe Coding(持續)
- 使用 Cursor、Copilot 等工具
- 從小專案開始,逐步建立信任
- 保持批判性思維,審查 AI 生成的程式碼
5.5 給技術從業者的深度建議
- 深入理解協議層:MCP 和 A2A 將成為基礎設施,理解它們的設計哲學
- 關注 Agent 架構:學習 ReAct、ToT、Reflexion 等推理模式
- 掌握編排能力:多 Agent 系統的協調、狀態管理、錯誤恢復
- 保持工程紀律:AI 再強大,軟體工程的基本原則依然適用
結語:人機協作的新紀元
從 Prompt Engineering 到 Context Engineering,從 Tool Use 到 Vibe Coding,我們正見證著人機協作方式的根本性轉變。
這不僅僅是技術的演進,更是認知正規化的轉移:
- 過去:人類告訴計算機”如何做”(How)
- 現在:人類告訴 AI”做什麼”(What)
- 未來:人類與 AI 共同探索”為什麼做”(Why)
在這個新時代,最寶貴的技能不再是記住最多的 API 或寫出最優雅的演算法,而是:
- 清晰表達意圖的能力 —— 知道你想要什麼
- 批判性評估的能力 —— 判斷 AI 輸出是否正確
- 系統思考的能力 —— 理解各部分如何協同工作
- 持續學習的能力 —— 適應快速變化的技術 landscape
正如 Vibe Coding 所揭示的,未來的開發者可能不再是”程式碼的編寫者”,而是”智慧的編排者”。而 Prompt Engineering、Context Engineering、Skills 這些層次,正是構建這個新世界的基石。
無論你是初學者還是資深工程師,現在都是最好的入場時機。因為在這個領域,每個人都在學習,每天都有新發現,每個參與者都有機會塑造未來。
參考資源
Prompt Engineering:
Context Engineering:
Agentic AI & Protocols:
- Model Context Protocol - Anthropic
- Agent2Agent Protocol - Google
- The Rise of Autonomous AI Agents
Vibe Coding: