BackdoorIndicator: Leveraging OOD Data for Proactive Backdoor Detection in Federated Learning
BackdoorIndicator: 利用分佈外(OOD)資料在聯邦學習中進行主動後門檢測
USENIX Security 2024:arvix
Southeast University Songze Li;HKUST(GZ) Yanbo Dai(東南大學+香港科技大學廣州)
介紹
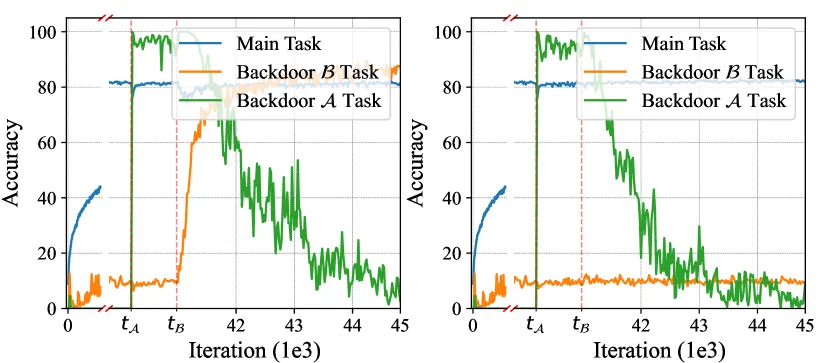
連續植入具有相同目標標籤的不同後門任務,後續的後門能夠顯著幫助維持先前植入後門的準確率,而不是將其覆蓋或銷燬。這是因為後門攻擊本質上指一種分佈外(OOD, out-of-distribution)任務,植入後門的過程,實際上是在不破壞原有正常ID對映的情況下,強行建立了一條從OOD特徵(即後門觸發器)到目標標籤的額外隱蔽通道(對映)。
並且,針對同一任務目標的 OOD 對映具有相同特性。
假設有兩個後門 A 和 B,具有相同的目標
如果停止植入後門A且不植入後門B:模型只接受正常的良性資料訓練,在這個過程中,模型只會不斷強化正常的ID對映,而之前建立的OOD對映,也就是後門A會逐漸被模型遺忘。
如果停止植入後門A,但開始植入後門B:後門B同樣是一個帶有OOD特徵的樣本,且指向相同的目標標籤。雖然觸發器變了,但模型依然被迫在某種OOD特徵與該目標標籤之間保持對映通道活躍,這樣特徵會被一定程度上保留。
因為後門A和後門B相對於良性資料來說,都具有分佈外的共同特性,後門B的訓練讓模型保持了對分佈外特徵的敏感性。因此,維持後門B的分佈外對映,順帶也保全了之前建立的後門A的分佈外對映,使其免於被正常的良性訓練資料沖刷掉
提出了一種主動防禦機制。伺服器在下發模型前,先注入一個基於分佈外資料的“指示器任務”。由於後門攻擊本質上也是在訓練 OOD 對映,惡意客戶端在訓練自己的後門時,會“順便”維持伺服器注入的指示器任務準確率,而良性客戶端則會遺忘它。透過檢查指示器,達到檢測攻擊的目的。
解決了現有防禦手段,如基於範數裁剪、距離聚類在低中毒學習率、Non-IID 資料分佈,這樣隱蔽攻擊條件下失效的問題。
在各種攻擊設定下,該方法均取得了最高的真陽性率(TPR)和最低的假陽率(FPR),且不依賴良性根資料。
-
TPR (True Positive Rate) - 真陽性率
- TPR 反映了檢測機制識別對抗性後門的能力,它的計算方式是:被正確識別出的惡意更新數量 / 惡意更新的總數。TPR 越高越好,數值越高,系統檢測出後門攻擊的能力越強。
-
FPR (False Positive Rate) - 假陽性率
- FPR 指示了檢測機制區分後門更新和良性更新的能力,它的計算方式是:被錯誤分類為惡意的良性客戶端數量 / 良性更新的總數。FPR 越低越好。數值越低,說明判錯的後門少。
-
BA (Backdoor Accuracy) - 後門準確率
- 當攻擊者停止投毒(注入後門)時,後門任務在全域性模型上的準確率。越低越好,BA 越低,說明儘管攻擊者拼命想植入後門,但防禦機制有效地阻止了後門在全域性模型中生效。
背景
在聯邦學習中,惡意客戶端可以透過上傳中毒的區域性模型,在全域性模型中植入後門。這種攻擊非常隱蔽,只在特定觸發器出現時才導致誤分類。
目前的防禦主流是被動檢測,即檢查上傳引數的統計特徵(如歐氏距離、餘弦相似度、L2範數等)。
痛點在於
-
統計特徵易偽造: 如果攻擊者使用較小的學習率,或者在高度 Non-IID的場景下,惡意更新的引數分佈會和良性更新非常接近,導致統計防禦失效。
-
防禦效能不穩定: 如 FLAME 等方法,在攻擊隱蔽時,TPR會迅速掉到0。
文章創新點
作者發現,如果在模型中先後植入兩個目標標籤相同的後門任務,即使觸發器不同,後植入的任務有助於維持先植入任務的準確率 。 這種機制也有一個前提,不要進行批歸一化(Batch Normalization, BN)統計量偏移。
如果直接去測,可能會覺得後門A的準確率在後門B加入後還是下降了,這是由批歸一化(Batch Normalization, BN)統計量偏移引起的。因為訓練資料從後門A變為了後門B,BN層估算的均值和方差發生了改變 。一旦在評估時使用之前儲存的正確BN統計量來消除這種偏移,就會發現後門A的準確率被極其顯著地維持住了。
作者提出,良性任務是學習分佈內(In-Distribution, ID)特徵,而後門任務是強行建立樣本,通常是 OOD(out-of-distribution) 的,與目標標籤的對映。
-
良性客戶端: 在訓練 ID 資料時,會發生災難性遺忘,導致對 OOD 任務的準確率下降。
-
惡意客戶端: 為了植入後門,必須維護這種 OOD 對映能力。因此,惡意客戶端在訓練自己的後門時,會無意中保護了伺服器注入的 OOD 指示器任務。
注:
批歸一化
是一種廣泛應用於加速和穩定深度學習模型訓練的技術,它在訓練期間使用當前批次資料的經驗均值和方差來標準化輸出,並在推理和測試階段使用整個訓練過程中積累的均值和方差的滑動平均值。
在本文中如果不處理 BN 偏移,當模型訓練資料的分佈發生改變,例如從訓練後門A變為訓練後門B時,模型內部估計的滑動均值和方差會逐漸偏離原來任務的資料分佈,導致當前儲存的統計量不再適用於評估模型在舊任務上的真實表現。結果就是後植入的後門無法維持前一個後門的準確率。
BackdoorIndicator說明
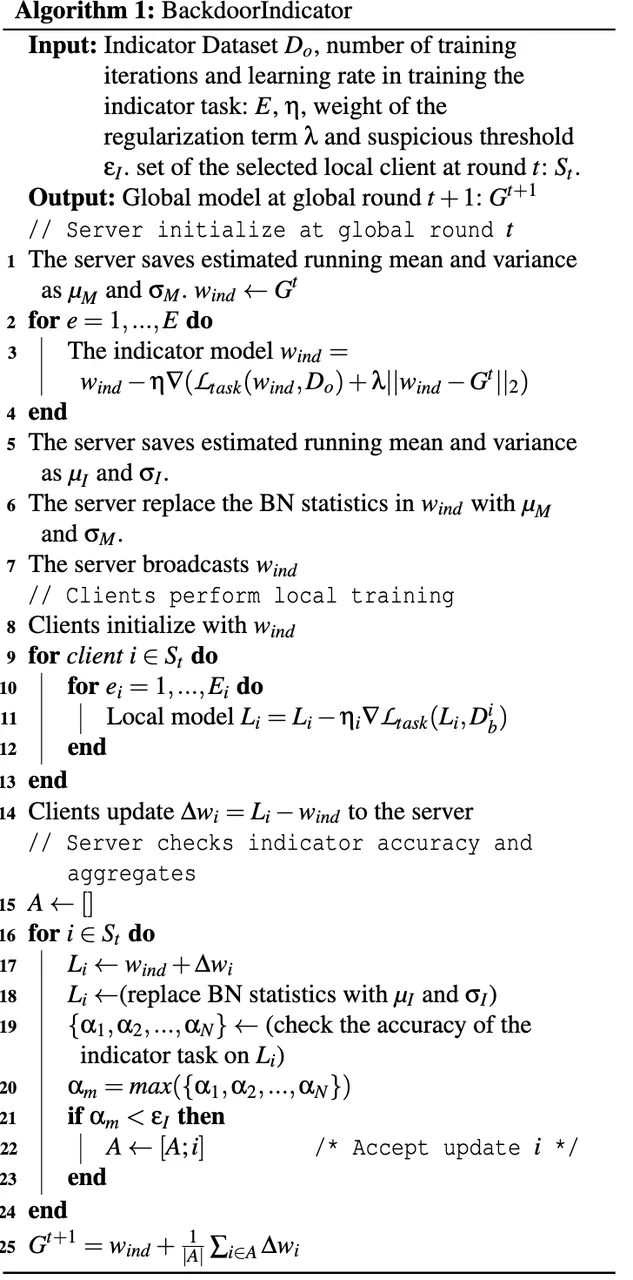
演算法輸入 (Input)
-
指示器資料集:,由分佈外 OOD 資料構成。
-
指示器任務訓練超引數:訓練迭代次數 和學習率 。
-
正則化項權重: ,用於控制指示器任務不對主任務產生過大影響
-
懷疑閾值: ,用於判定模型是否惡意的界限
-
參與客戶端:第 輪被隨機選中的客戶端集合
演算法輸出 (Output)
- 下一輪的全域性模型:經過過濾和聚合後生成的第 輪全域性模型
第一階段:伺服器初始化與指示器注入
在這個階段,伺服器負責把指示器任務植入到下發的模型中。
-
儲存原始統計量:伺服器儲存當前全域性模型 的批歸一化均值和方差,分別記作 和 。初始化指示器模型 。
-
訓練指示器任務:伺服器在指示器資料集 上對模型進行 次迭代訓練。訓練過程最佳化的損失函式不僅包含交叉熵損失,還加入了一個 L2 正則化項 以防止模型偏離主任務過遠
-
儲存新統計量:指示器任務訓練完成後,伺服器記錄此時模型新的 BN 均值和方差,記作 和
-
恢復原始統計量:為了消除植入指示器任務對主任務準確率的干擾,伺服器強制將模型 中的 BN 統計量替換回第一步儲存的 和
-
模型下發:伺服器將處理好的模型 廣播下發給本輪選中的所有客戶端
第二階段:客戶端本地訓練 (Clients perform local training)
在這個階段,客戶端在本地進行常規的聯邦學習訓練。
-
本地初始化:客戶端接收到伺服器下發的模型 ,並以此作為本地模型的初始狀態
-
執行本地訓練:被選中的各個客戶端使用自己本地的私有資料集進行梯度的迭代下降訓練,得到更新後的本地模型
-
上傳模型差異:客戶端計算本地訓練後的模型與收到的初始模型之間的引數差值 ,並將該差值更新上傳回伺服器
第三階段:伺服器檢測與聚合 (Server checks indicator accuracy and aggregates)
伺服器透過校正偏移並測試指示器任務來剔除後門模型。
-
初始化白名單:伺服器初始化一個空的集合 ,用於存放透過安全檢測的良性客戶端索引
-
校正 BN 偏移:針對客戶端上傳的每一個模型更新,伺服器先還原出其本地模型 。隨後,**將該模型的 BN 統計量強制替換為之前儲存的指示器統計量 和 **
-
盲測指示器準確率:伺服器在該模型上測試指示器資料集 中各個標籤類別的準確率,得到一個準確率陣列
-
提取最高分:從上述陣列中找出最高的準確率,記為 即該模型對指示器任務的記憶程度
-
閾值判定過濾:
-
如果 ,最高準確率低於懷疑閾值:說明客戶端在正常的良性訓練中已經遺忘了該誘餌任務,判定為良性更新,將該客戶端加入白名單集合
-
如果 :說明該更新保留了 OOD 對映,被判定為疑似後門更新,將其直接剔除,不加入集合
-
-
安全聚合:伺服器將白名單集合 中所有良性客戶端的更新進行平均聚合,生成用於下一輪訓練的新全域性模型:
除了上面的演算法,還有一些問題
伺服器對潛在後門的型別、觸發器以及目標標籤完全未知。為了解決這個資訊不對稱的問題,論文作者在實驗和演算法設計中採用了一種全面撒網,取其最高的策略,在植入階段覆蓋所有標籤,檢測階段獨立計算,取最大值。
透過這種設計,伺服器無需提前去猜攻擊者的目標標籤。這使伺服器不必預先知道目標標籤。不過,檢測效果仍然依賴 OOD 資料、訓練設定和閾值;它是論文實驗支援的方法,不是對任意後門的無條件保證。
實驗結果
作者在 CIFAR10, CIFAR100, EMNIST 等資料集上,測試了包括 Pixel-pattern, Semantic, Edge-case 等多種後門型別,以及 PGD, Neurotoxin, Chameleon 等多種攻擊演算法。
例如原論文表 4中的 CIFAR10 單客戶端、Vanilla 像素後門實驗:在非 IID 引數 α=0.2、惡意學習率 0.01 的設定下,FLAME 的 TPR 為 0%,BackdoorIndicator 為 98.0%。但後者的 FPR 仍有 19.7%,不能只看高檢出率就說誤報可以忽略;這個結果也不能推廣到所有任務和攻擊設定。
下面保留的是論文表 2 截圖,屬於另一組比較設定;上面學習率 0.01 的數字來自表 4,需要分別看。
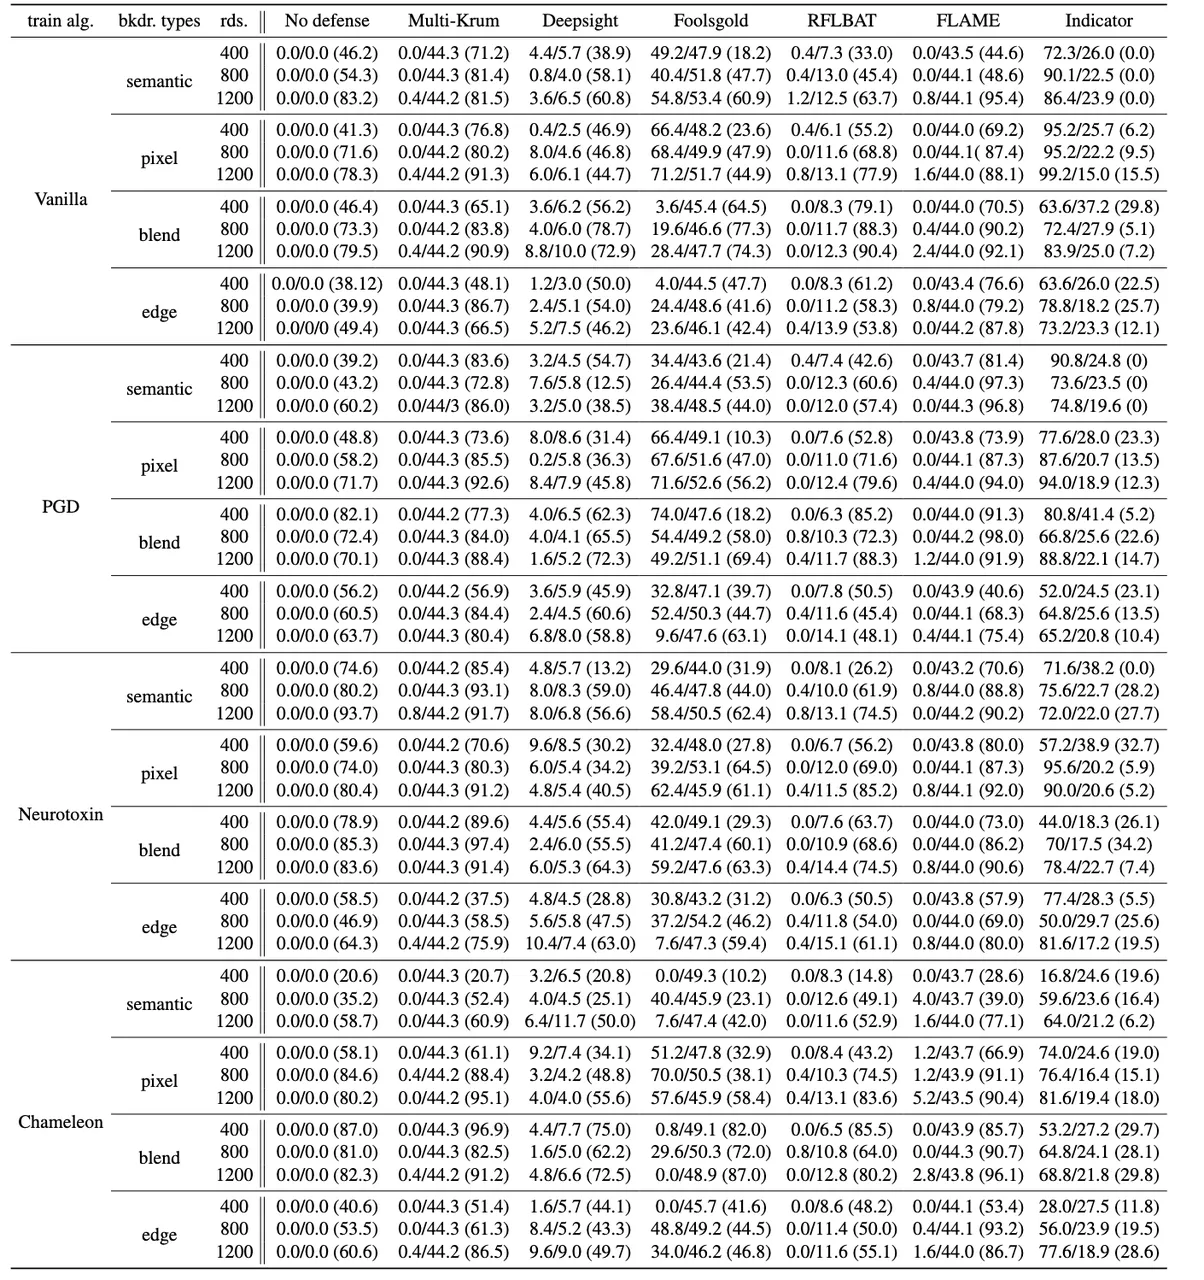
- 惡意訓練演算法 (train alg.):
-
Vanilla:基礎後門訓練。最傳統的做法,直接把帶有後門的髒資料和乾淨資料混在一起,透過交叉熵損失進行常規訓練。
-
PGD (Projected Gradient Descent):投影梯度下降訓練。一種高階演算法,它會在訓練時限制模型引數的變化範圍,目的是騙過那些一看到引數變化太大就報警的範數裁剪防禦機制
-
Neurotoxin:神經毒素攻擊。尋找那些良性客戶端平時極少更新的模型引數區域,偷偷把後門種在這些冷門區域,從而讓後門極其持久,極難被正常訓練沖刷掉
-
Chameleon:變色龍攻擊。利用監督對比學習技術,深度調整後門特徵和良性特徵在隱空間的距離,使其具備超強的隱蔽性和永續性
- 後門觸發器型別 (bkdr. types):
-
semantic:語義後門。不需要人為在圖片上亂塗亂畫,而是利用物理世界自然存在的特徵,例如只要背景裡有垂直條紋的牆,這輛車就會被識別錯”
-
pixel:像素後門。最經典的觸發器,在圖片的固定位置貼上幾個特定的像素點或圖案組合
-
blend:混合後門。將特定的隨機噪聲圖與正常的原始影象以一定的透明度混合在一起,人眼極難察覺
-
edge:邊緣情況後門。專門針對輸入資料分佈的長尾部分投毒,這種資料與正常的良性資料衝突極小,因此更加隱蔽且耐用
- 對比的防禦基線方法
-
Multi-Krum:一種基於歐氏距離計算的拜占庭魯棒聚合演算法,試圖找出那些距離其他更新最遠的異類並剔除
-
Deepsight:透過極細粒度地檢查模型。比如模型神經元輸出分佈、預測分數的差異來聚類並試圖揪出異常的防禦機制
-
Foolsgold:核心假設是好人的資料是千差萬別的,但壞人的目標永遠是高度一致的。它透過計算歷史更新的餘弦相似度,給那些行為太相似的客戶端降低聚合權重
-
RFLBAT:利用主成分分析(PCA)技術進行降維,把高維難以分辨的差異放大,然後在低維空間利用聚類(K-means)和歐氏距離剔除異常值
-
FLAME:先聚類剔除偏差太大的,然後強制裁剪模型更新幅度,最後對模型進行高斯噪聲,把殘存的後門給淹沒掉
個人思考和總結
從統計差異 找不同的被動檢測 轉變為釣魚式的主動檢測。
利用了深度學習中分佈外泛化和遺忘的本質特性,而不是依賴脆弱的引數分佈假設。
適用於分類+影象任務
我們是多模態的,文章提出的方法是針對影象的,研究多模態+聯邦+後門攻擊?
開原始碼復現流程
下面是對照作者程式碼整理的準備流程,還沒有在這裡補上個人復現實驗結果。論文裡的數字也仍然是作者的實驗結果。
1、先固定程式碼和環境
官方實現是 ybdai7/Backdoor-indicator-defense。README 給出的參考環境為 Python 3.7.15、PyTorch 1.13.0、torchvision 0.14.0。不要直接在現有的其他模型環境裡混裝,先建獨立環境,並檢查 CUDA 與 PyTorch 的匹配關係。
git clone https://github.com/ybdai7/Backdoor-indicator-defense.git
cd Backdoor-indicator-defense
git rev-parse HEAD
python -m pip install -r requirement.txt
把輸出的提交號和最終依賴版本一起儲存。這裡的檔名是單數 requirement.txt,不是常見的 requirements.txt。
2、確認資料與實驗設定
先選定論文中的一個實驗場景,再檢查 ID 資料、OOD 資料、模型、客戶端數量、資料劃分和訓練輪數。不要一開始就同時改很多引數,否則很難知道差異來自哪裡。
作者的指示器配置檔案裡同時包含模型、資料來源和訓練階段設定。啟動前至少核對 dataset、ood_data_source、resumed_model,以及兩個階段的開始輪數;是否從檢查點恢復,要與比較的其他實驗保持一致。
3、先做基線,再開指示器
上游建議先訓練並儲存基礎模型的檢查點,再從檢查點比較防禦方法。最先確認的不是“檢測率能有多高”,而是正常訓練和評估是否跑通,儲存與恢復的模型是不是同一個。
確認依賴、資料和配置後,入口命令是:
python main.py --GPU_id 0 --params utils/yamls/indicator/params_vanilla_Indicator.yaml引數大小寫和路徑以實際入口程式碼為準。輸出目錄是 saved_models;每次實驗同時保留配置、依賴版本和日誌,不只儲存最後一個數字。
4、對比哪些指標?
至少把正常任務準確率、後門攻擊成功率、檢測的 TPR/FPR、額外訓練開銷分開記錄。還要註明資料劃分、客戶端取樣、隨機種子、攻擊設定和比較輪數。
檢測率高,但正常客戶端大量被誤判,也不能直接說方法好。之後可以逐項改變 OOD 資料規模、閾值和客戶端分佈,看結果是否穩定。
適用邊界再想一下
這篇文章討論的是特定聯邦分類設定中的後門檢測。把它搬到多模態任務裡,不能只把資料集換掉:指示器任務如何定義,圖文表示是否存在類似的保留現象,以及錯誤拒絕客戶端會不會影響其他能力,都要重新實驗。
這些是後續研究問題,不能把影象分類實驗的結論直接當作多模態場景已經成立。