本篇文章記錄DataWhale微學習中課程—從零打造RAG檢索系統
推一波DataWhale的學習內容,可以關注DataWhale公眾號,選擇自己喜歡的內容
學習內容原作者的公眾號: 從零打造RAG檢索系統:BM25讓檢索快到飛起 github倉庫地址: XiaokeAILabs
文章重點是瞭解RAG檢索的基礎,執行作者程式碼測試工具效果
1、RAG及相關基礎概念
1.1、什麼是RAG
RAG(Retrieval-Augmented Generation,檢索增強生成)是一種結合檢索和自然語言生成的技術,旨在提高生成模型的效能和效果。RAG的基本思想是在生成模型的輸入中同時包含檢索到的相關資訊,從而提高生成模型的生成質量和準確性。
想起之前使用過Langchain結合ChatGLM3-6B模型,實現過一個智慧漏洞問答系統,用的應該就是RAG,不過當時對這些概念並不瞭解。
在日常使用中的kimi、豆包和加入聯網功能的DeepSeek,應該都應用到了這種技術,不過他們的實現原理和演算法應該更加複雜,實現細節上可能也有不同。
1.2、RAG的基本流程
RAG的基本流程還是比較簡單的,可以分成兩個階段:
- 索引階段:預處理並儲存文件資料,構建檢索索引
- 查詢階段:接收使用者查詢,檢索相關文件,將文件資訊作為生成模型的輸入,生成相應的回答
1.3、RAG系統核心元件
想要實現一個完整的RAG過程需要上傳並處理額外的文件和資料,這些資料可以是文字、影象、音訊、影片等。然後要對這些資料進行處理,比如對文字進行分詞、去除停用詞、向量化……
之後要構建檢索索引,這一步可以使用多種演算法,比如BM25、TF-IDF、向量檢索等。
最後就是生成模型,根據使用者輸入的資訊,檢索額外資料,將檢索到的資訊與使用者查詢結合,透過LLM生成最終答案。
核心部分可以分成
- 資料處理
- 檢索索引
- 生成模型
當然這是我自己的概括,不準確
1.4、BM25演算法
BM25(Best Matching 25)是一種經典的資訊檢索演算法,是基於Okapi TF-IDF演算法的改進版本,旨在解決Okapi TF-IDF演算法的一些不足之處。它被廣泛應用於資訊檢索領域的排名函式,用於估計文件D與使用者查詢Q之間的相關性。BM25是一種基於機率檢索框架的改進,特別是在處理長文件和短查詢時表現出色。它旨在評估一組查詢項與文件的相關性,併為每個文件計算一個分數,該分數決定了文件在搜尋結果中的排名。BM25的核心思想是基於詞頻(TF)和逆文件頻率(IDF),同時還引入了文件的長度資訊來計算文件D和查詢Q之間的相關性。目前被廣泛運用的搜尋引擎ES就內建了BM25演算法進行全文檢索。
具體計算公式就不詳細介紹了。
除了BM25,還有很多其他的檢索演算法,比如TF-IDF、向量檢索、語義檢索等。
2、基於BM25的RAG檢索系統執行
2.1、環境配置
環境配置的過程一波三折,可能用linux環境執行更好?
Python版本: 3.10+
環境管理工具: conda
開啟cmd,使用下面的命令直接建立環境
conda create --name RAG python=3.102.2、git專案到本地
原作者的github倉庫地址XiaokeAILabs
可以使用下面的指令直接git到本地
git clone https://github.com/li-xiu-qi/XiaokeAILabs.git2.3、安裝依賴
先進入專案中的xiaoke_doc_assist_by_bm25資料夾,然後在該目錄下進入cmd
首先使用下面的指令安裝依賴
pip install -r requirements.txt安裝完成後在當前目錄下建立 .env 檔案,檔案內容可以複製 .env.example 中的
這裡要配置呼叫模型的API,我之前在矽基流動免費領過額度,所以跟作者一樣使用矽基流動的API和金鑰
如果使用矽基流動,直接修改 API_KEY=your_api_key
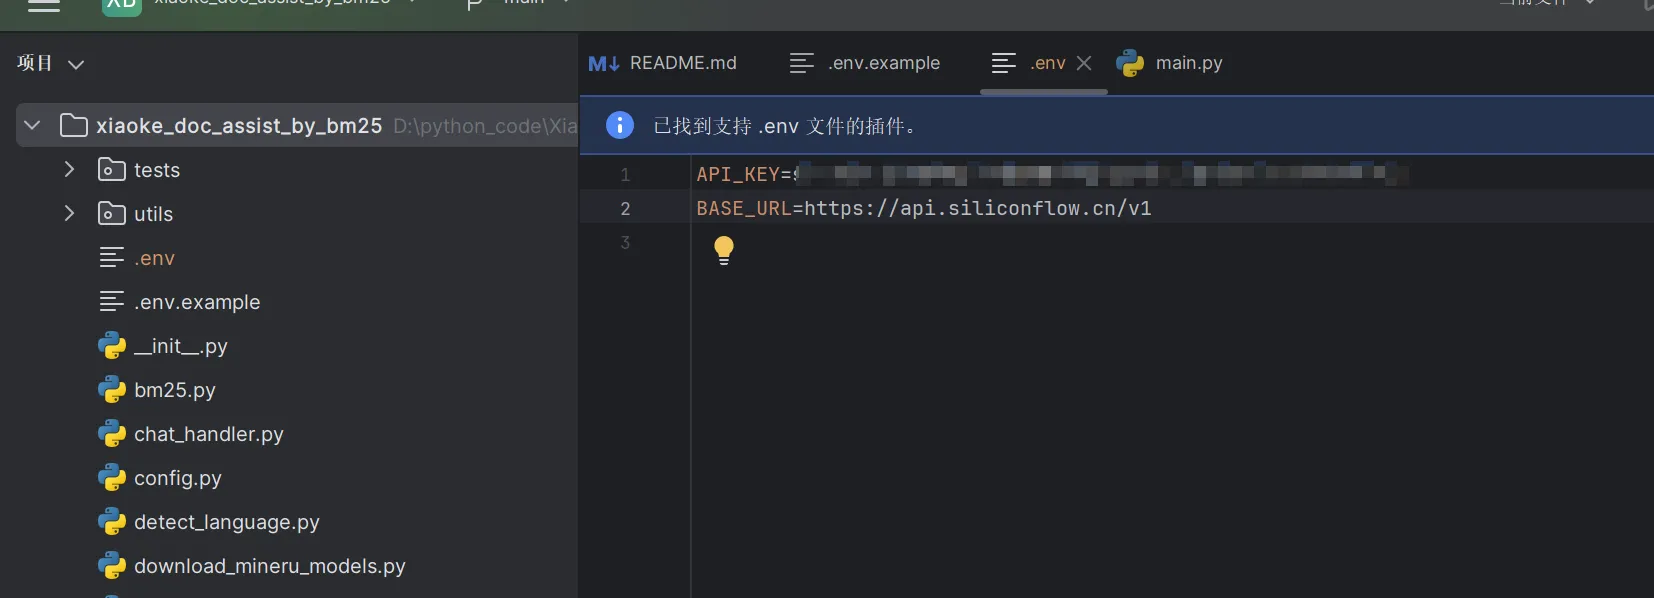
也可以使用其他平臺的API,比如 OpenAI、火山等,要修改 API_KEY 和 BASE_URL
配置好後還要下載MinerU模型,用於高質量PDF解析
在當前目錄下使用下面指令,如果開了IDE也可以直接執行python檔案
python download_mineru_models.py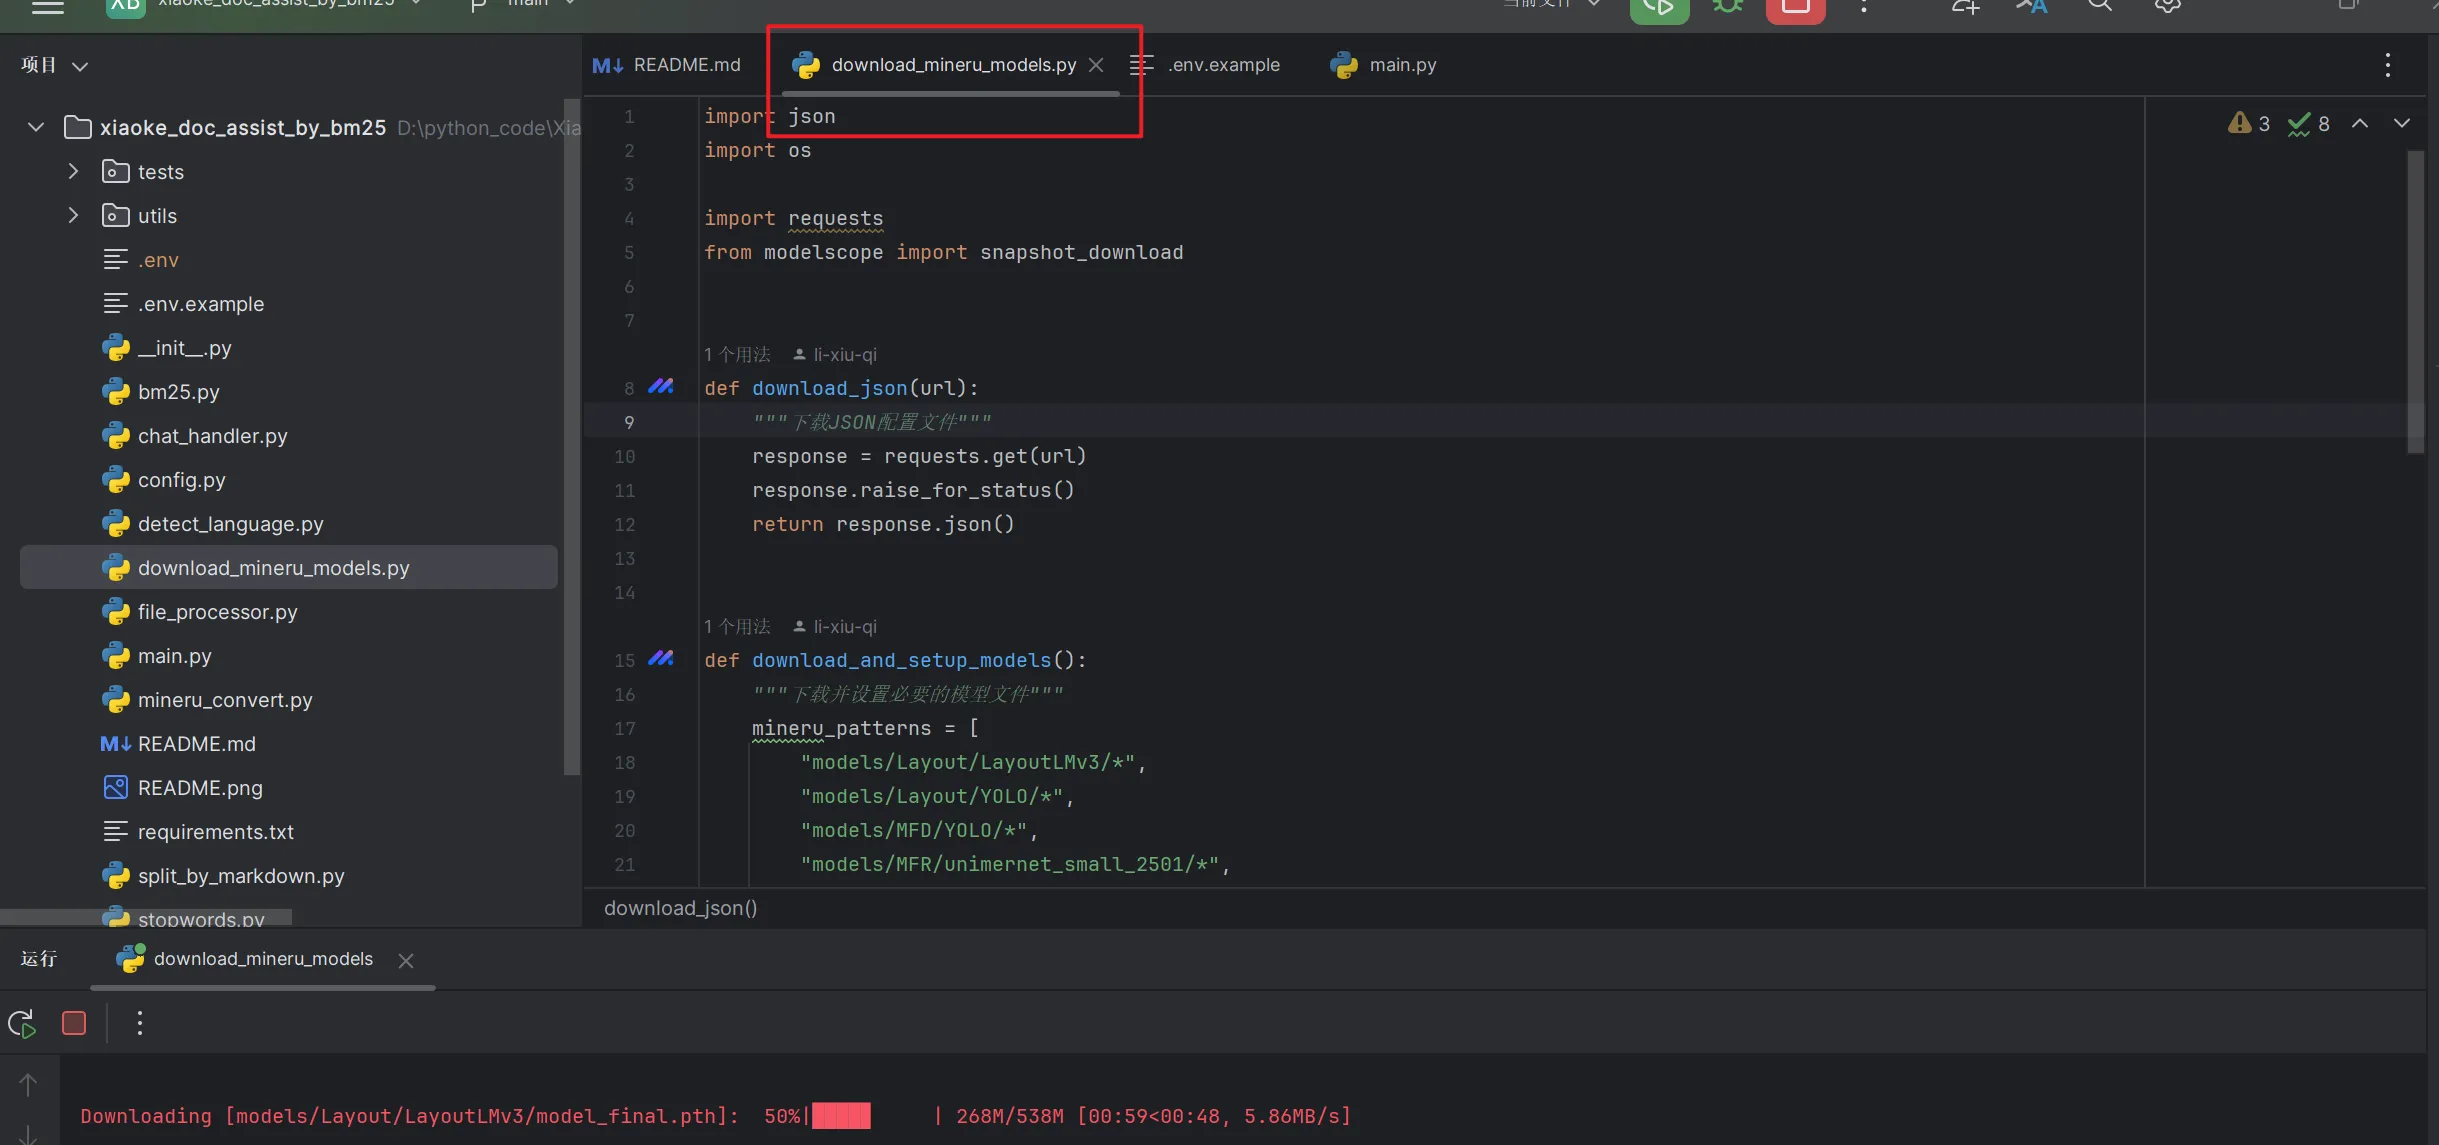
2.4、執行專案
在當前目錄下使用下面指令執行專案
streamlit run main.py當然,這只是開始,我們仍舊有很多潛在的依賴沒有安裝,由於不知道安裝啥,只能一遍遍執行啟動專案的指令,根據報錯資訊安裝,直到最後專案成功啟動。
總的來說,缺啥補啥,最後會執行成功的。
下面是我的辛路歷程
1、缺少magic-pdf
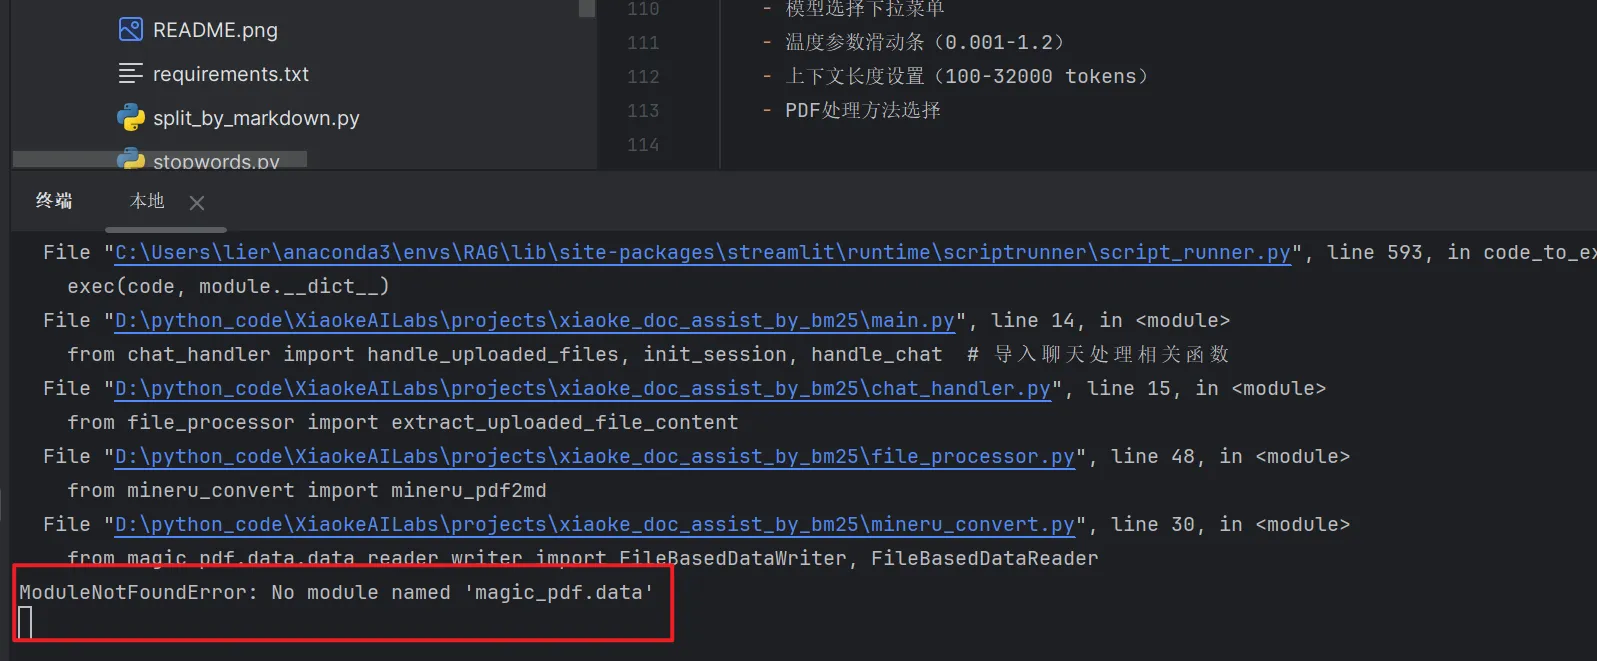
檢查後這裡需要升級magic-pdf
使用指令
pip install --upgrade magic-pdf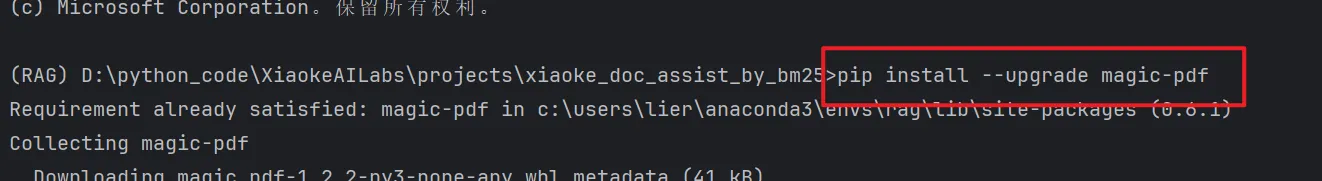
2、缺少paddle
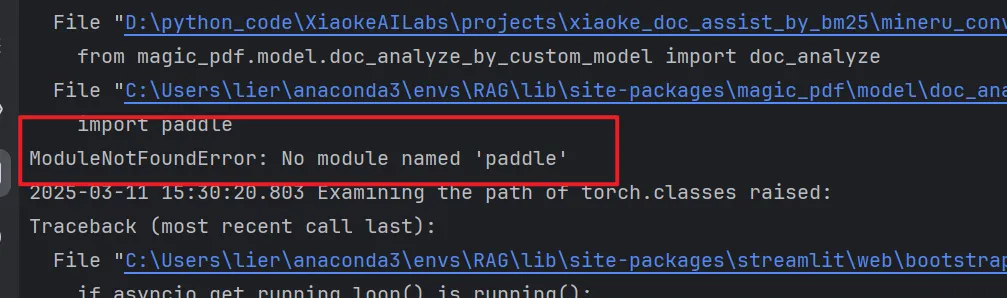
安裝paddle
pip install paddle但是還會報錯,缺少paddle的依賴
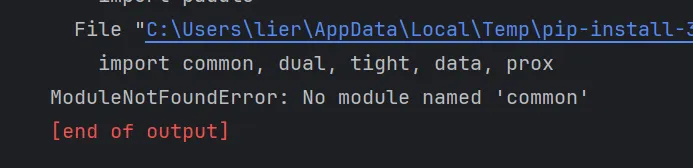
安裝依賴
pip install common dual tight data prox安裝之後發現還是報錯
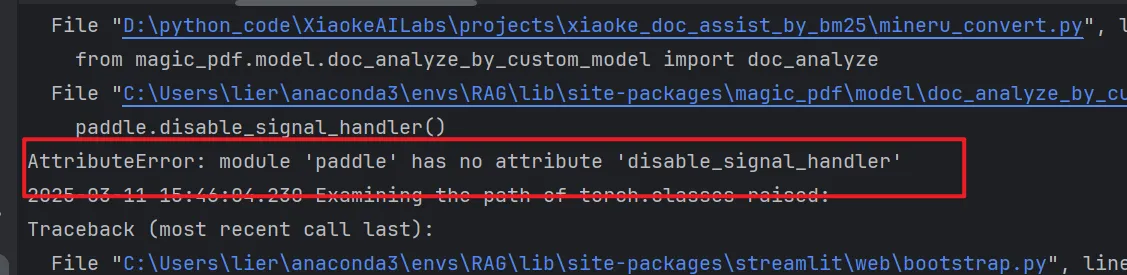
搜尋發現paddle太老了,應該升級安裝paddlepaddle
安裝指令
pip install --upgrade paddlepaddle3、缺少cv2
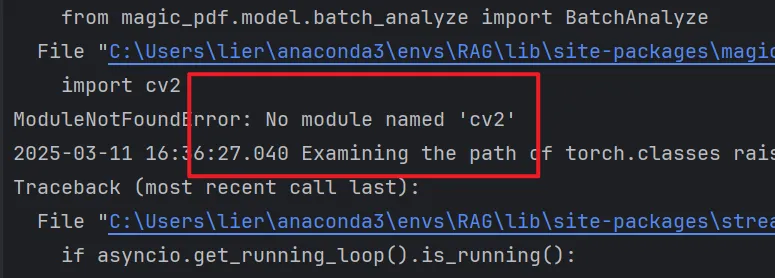
安裝依賴
pip install opencv-python
4、缺少ultralytics
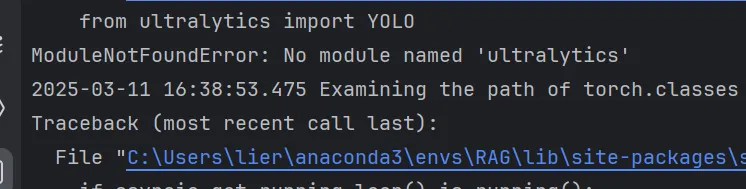
安裝依賴
pip install ultralytics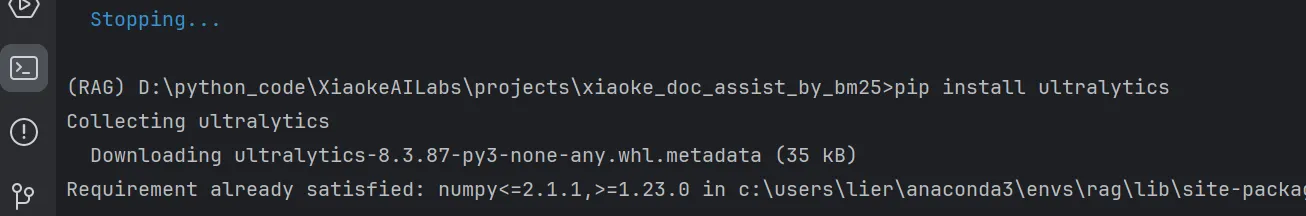
5、缺少doclayout_yolo
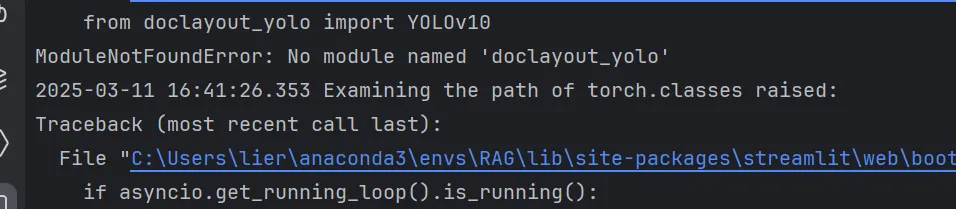
安裝依賴
pip install doclayout_yolo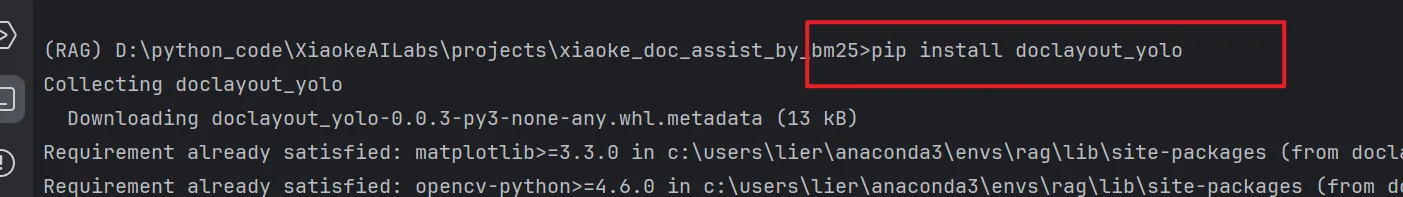
6、缺少pycocotools
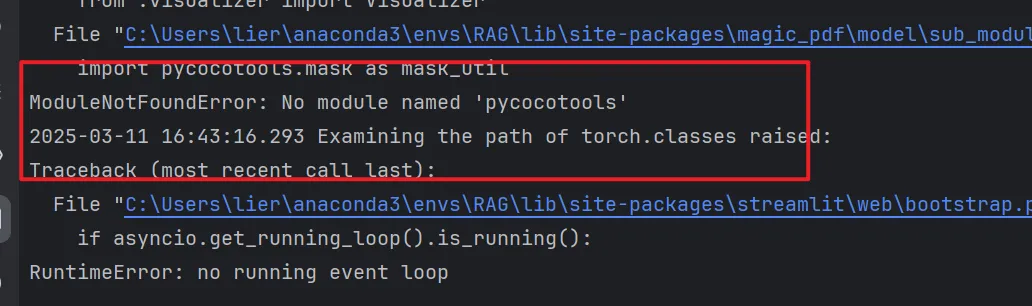
安裝依賴
pip install pycocotools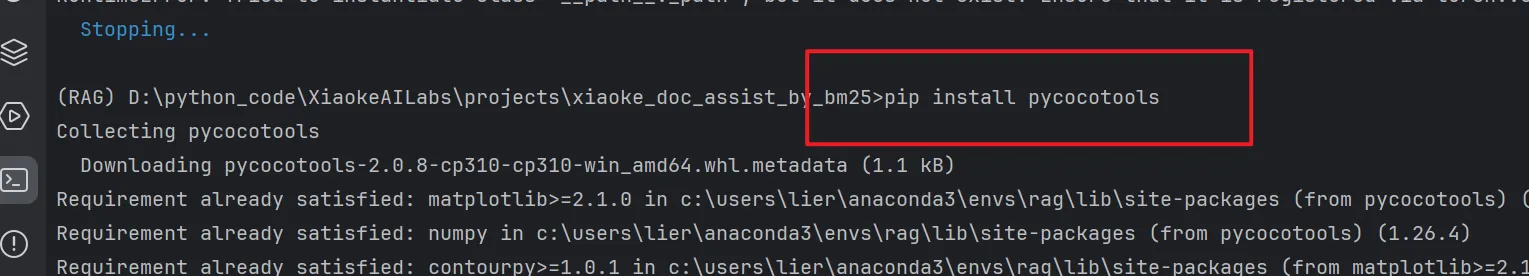
7、缺少detectron2
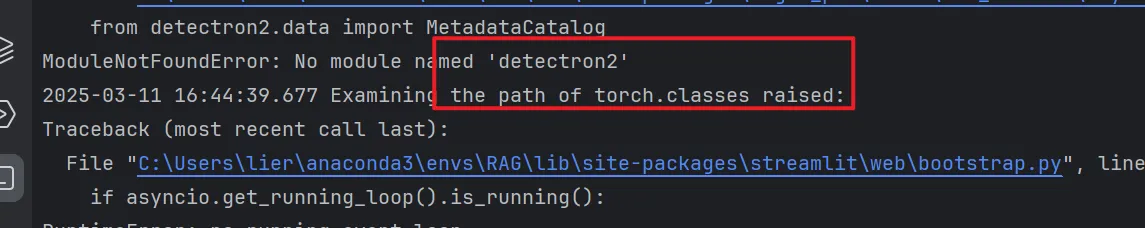
安裝依賴
這個依賴的安裝可以參考部落格Windows11安裝detectron2全流程記錄帖(含torch安裝)
這個過程中可能會報錯,缺少ninja
使用下面指令安裝
pip install ninja還會報錯要安裝Microsoft C++ Build Tools,可能是缺少C++編譯器?
如果有這個報錯點選連線,安裝就行,在安裝的時候一定要勾選C++桌面開的部分
解決上面兩個問題後安裝應該不會有問題
8、缺少timm
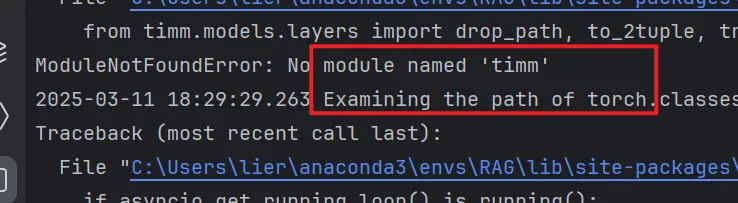
安裝依賴
pip install timm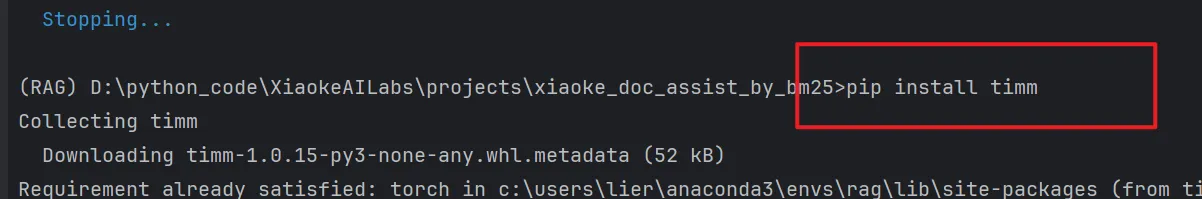
9、缺少unimernet
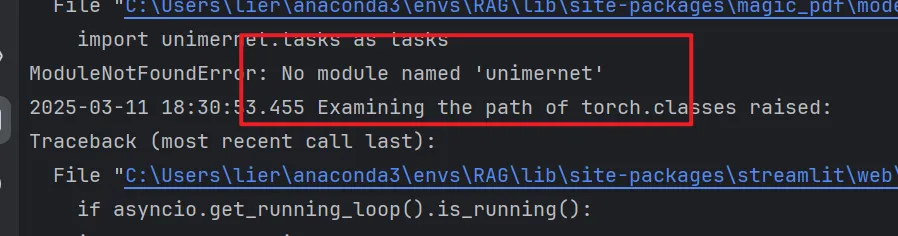
安裝依賴
pip install unimernet
10、缺少paddleocr
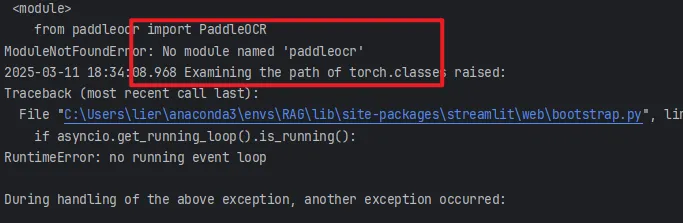
安裝依賴
pip install paddleocr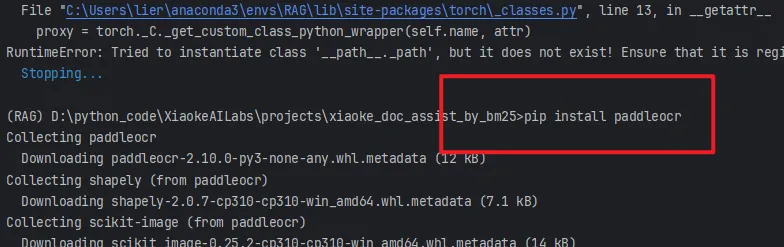
11、缺少rapid_table
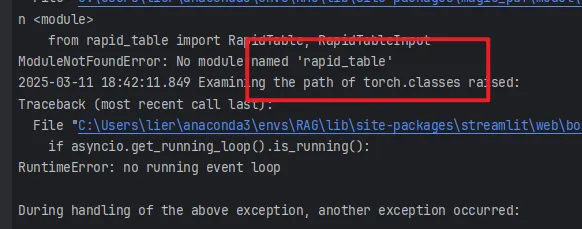
安裝依賴
pip install rapid_table12、缺少struct_eqtable
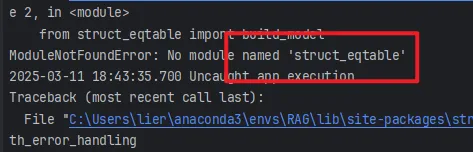
安裝依賴
pip install struct_eqtable
13、缺少Stemmer
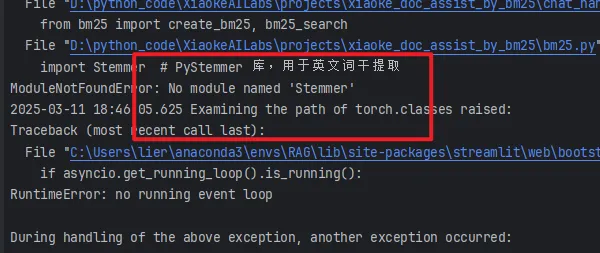
安裝依賴
pip install PyStemmer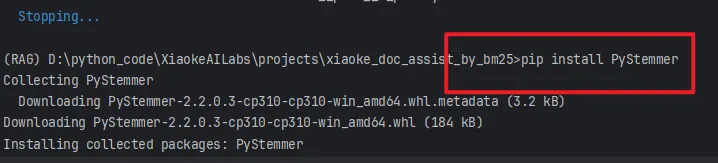
現在應該能正常執行專案了?
在執行起來之後,我嘗試上傳檔案,還有一個報錯安裝依賴
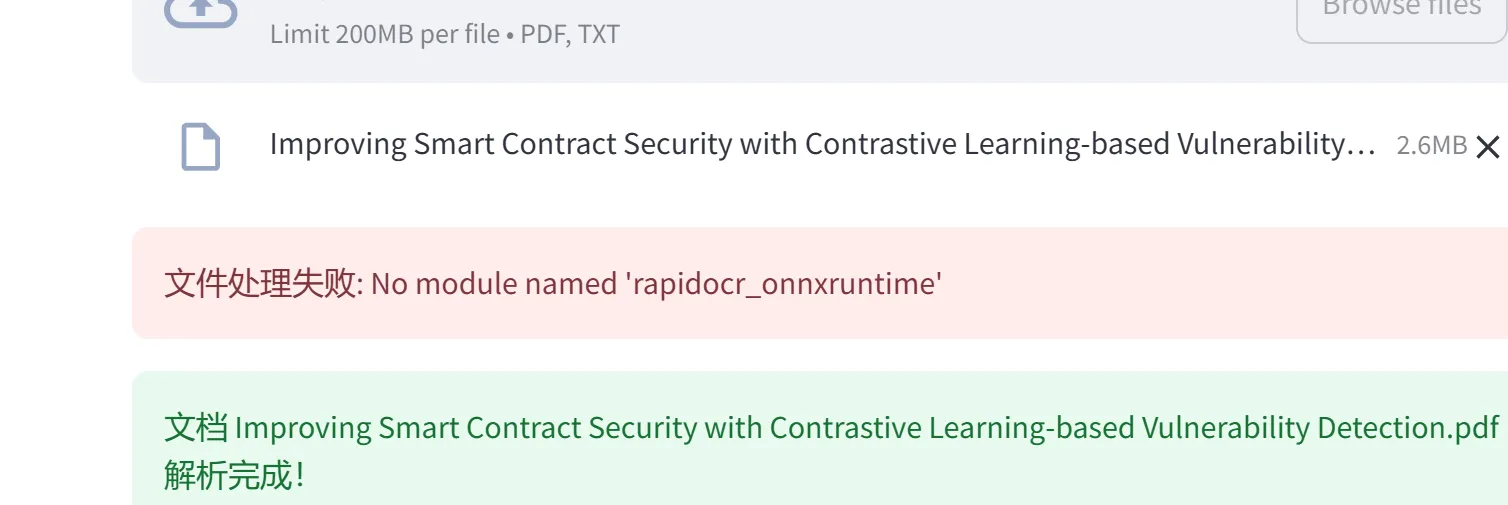
安裝依賴
pip install rapidocr_onnxruntime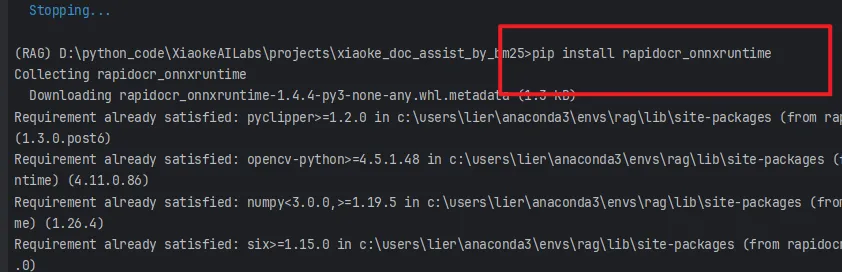
現在確實可以執行了
3、專案效果
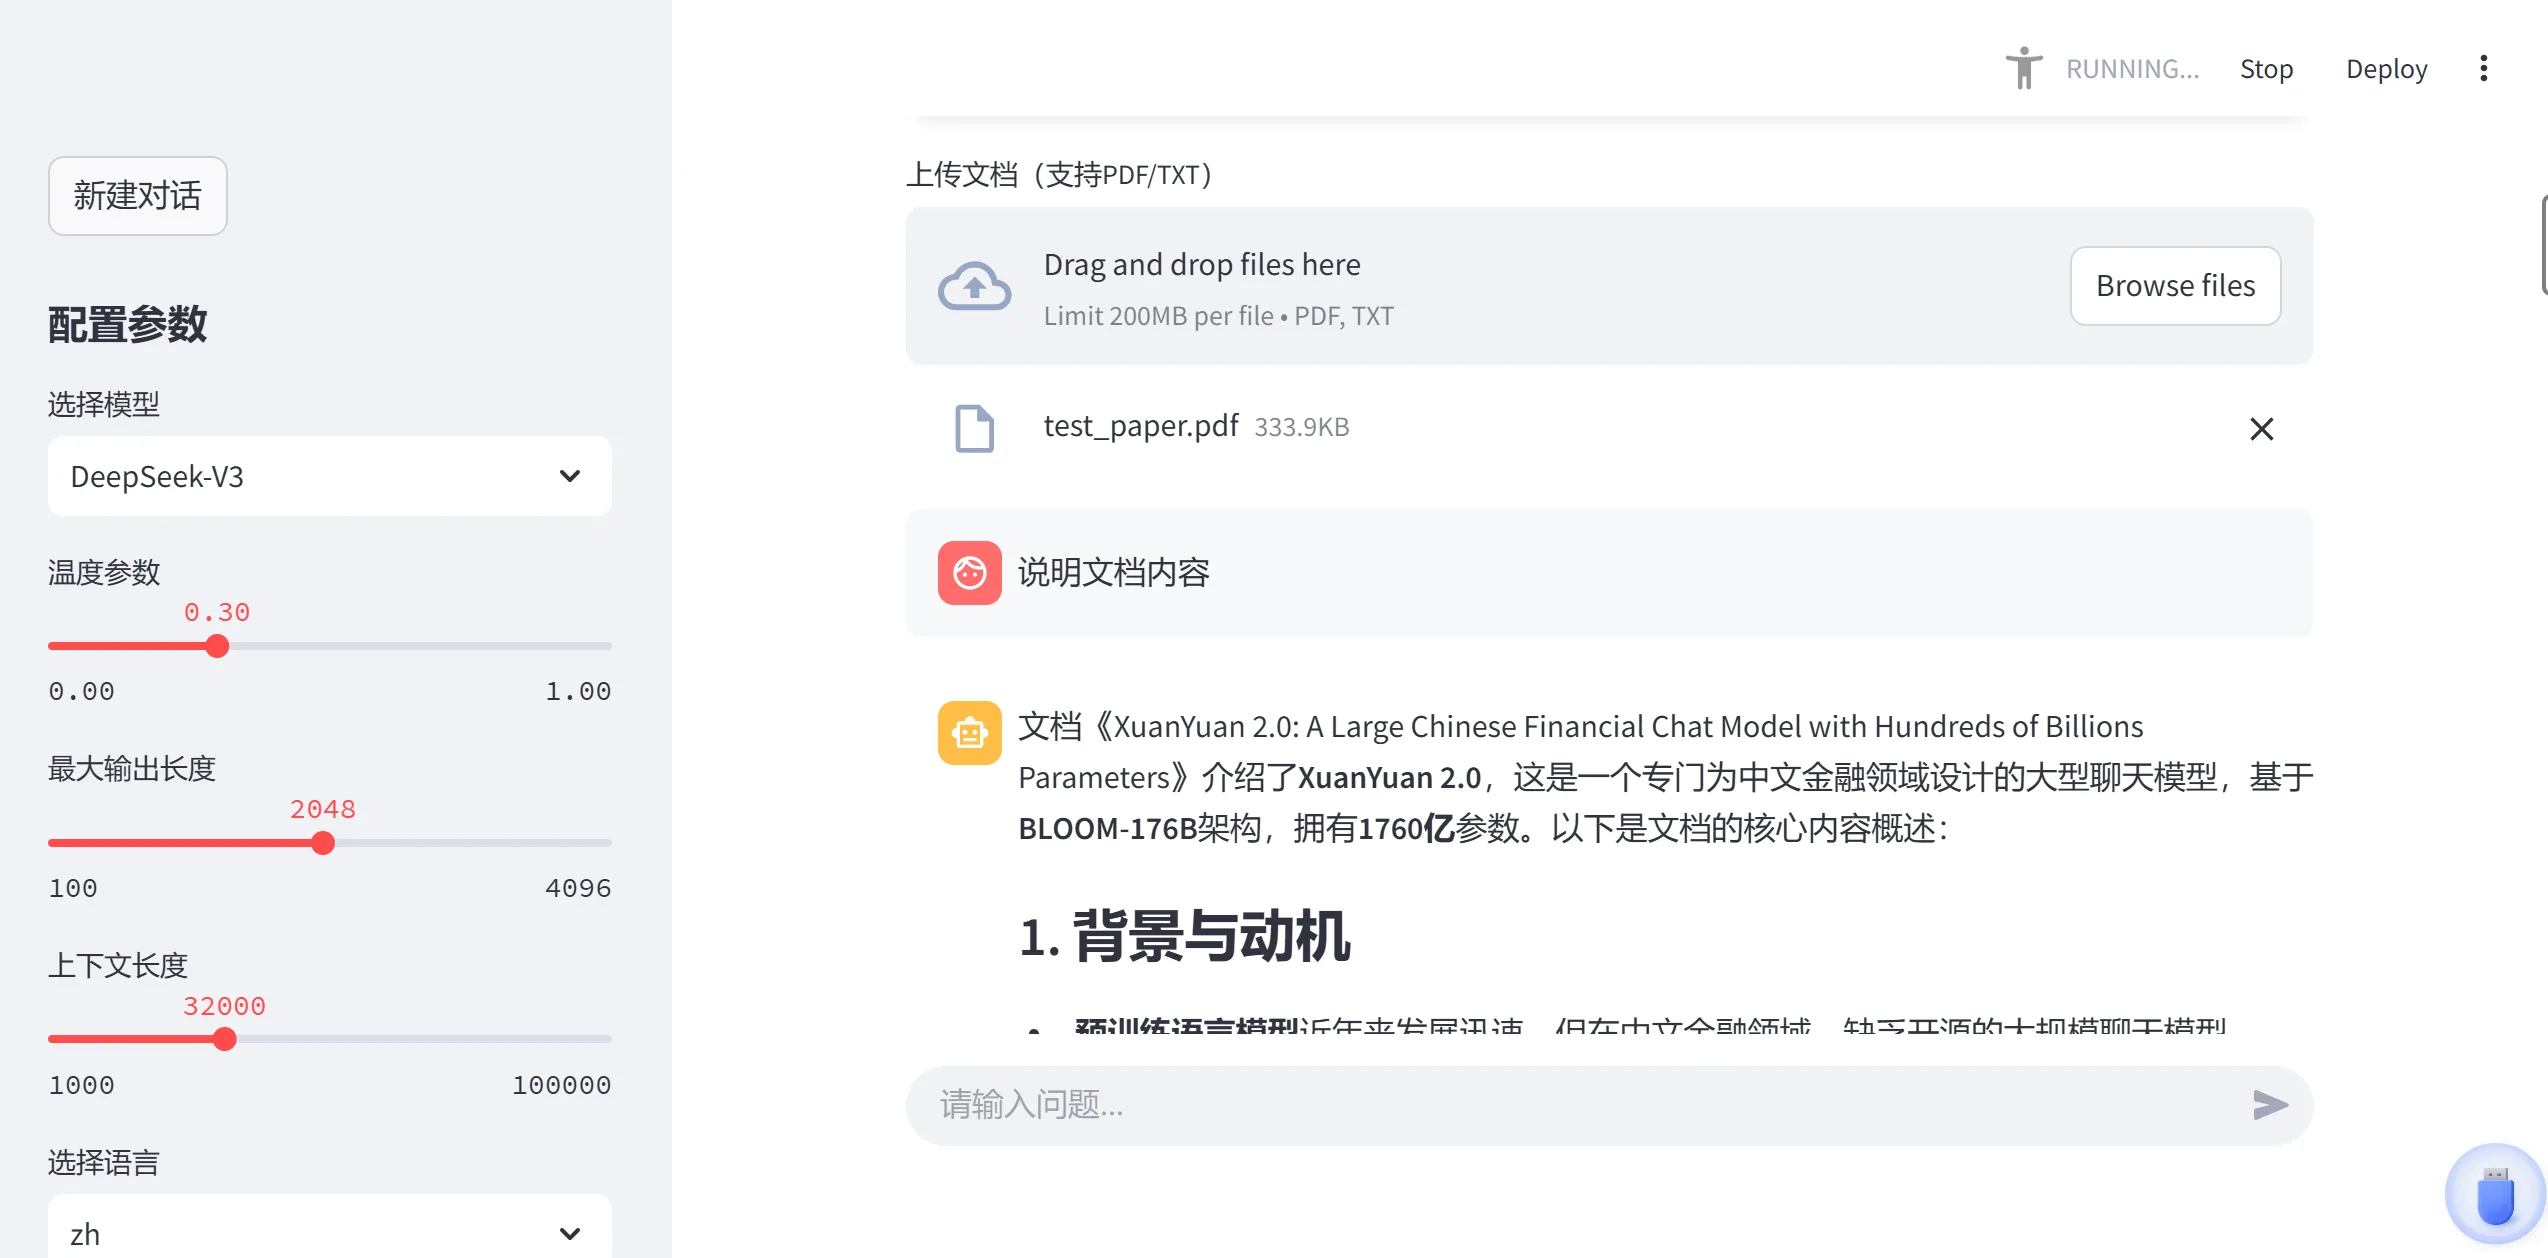
在執行完成後,我上傳了自己桌面上的一個論文,經過測試可以成功解析,但是不能夠檢索內容並餵給大模型,還沒找到原因。
之後我用作者提供的測試論文,發現可以成功執行。
貼一張圖:
4、總結
這是一個非常簡單(可能也沒那麼簡單),但是非常有意思的RAG檢索系統,但是可以作為一個學習的起點,瞭解RAG檢索的基本流程和原理。
在實際應用中,RAG檢索系統的實現可能會更加複雜,需要考慮更多的因素,比如資料處理、檢索索引、生成模型等。
現在執行專案還會有很多問題,後續我也會發現原因,或許實踐構建一個自己的RAG檢索系統?