VLM(Vision-Language Model): 視覺語言大模型
視覺語言模型(Vision-Language Model,VLM)是人工智慧領域最激動人心的進展之一。它讓機器能夠同時”看懂”影象和”理解”語言,開啟了人機互動的全新正規化。本文將帶你從零開始,全面瞭解 VLM 的原理、發展與未來。
一、什麼是視覺語言模型?
1.1 通俗理解:給 AI 裝上”眼睛”
想象一下,如果你能和一臺機器這樣對話:
你:“請描述這張圖片裡有什麼?“
AI:“圖中有一隻金毛犬在草地上奔跑,背景是藍天白雲,遠處還有幾棵樹。”
或者更復雜一點:
你:“這張圖表顯示了什麼趨勢?“
AI:“這張柱狀圖顯示了 2020-2024 年公司營收的逐年增長趨勢,其中 2023 年增長率最高,達到 35%。”
這就是視覺語言模型(VLM)的能力——它能夠同時處理視覺資訊(影象、影片)和語言資訊(文字),並在兩者之間建立聯絡。
根據 IBM 的定義,視覺語言模型是將**計算機視覺(CV)與自然語言處理(NLP)**功能融合到統一系統中的多模態模型。簡單來說,VLM = 視覺理解 + 語言理解。
1.2 技術定義:多模態 AI 的集大成者
從技術角度看,VLM(也常被稱為 Large Vision-Language Models,LVLMs)通常由三個核心元件構成:
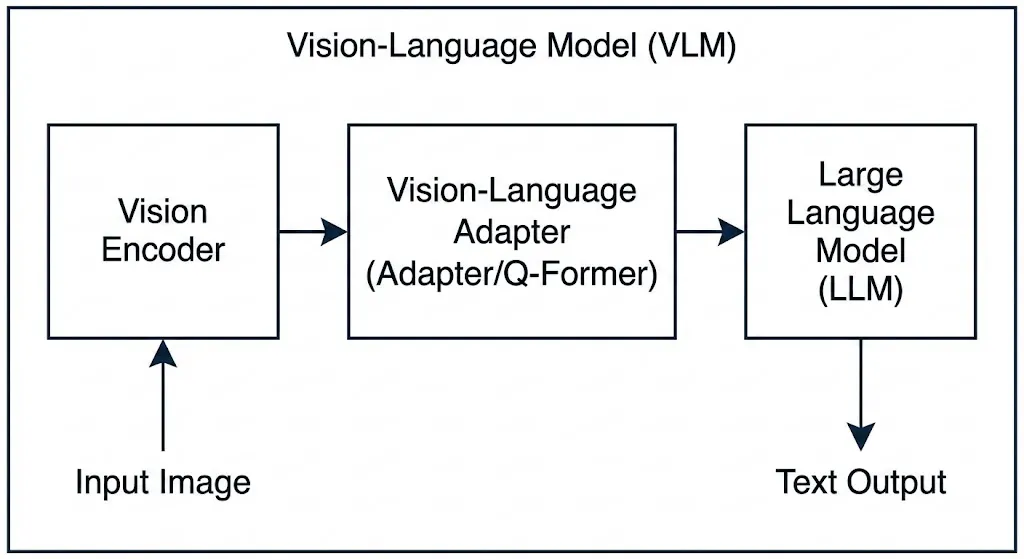
三個核心元件的作用:
-
視覺編碼器(Visual Encoder):負責從影象中提取視覺特徵。通常使用 Vision Transformer(ViT)架構,如 CLIP-ViT、EVA-CLIP 等。它將輸入的影象轉換為模型可以理解的”視覺 token”序列。
-
視覺-語言介面卡(Vision-Language Adapter):作為視覺和語言之間的”橋樑”,將視覺特徵對映到大語言模型的嵌入空間。常見設計包括:
- 單層線性投影(如 LLaVA)
- 帶非線性的 MLP(如 MiniGPT-4)
- Q-Former 架構(如 BLIP-2)
-
大語言模型(LLM):負責理解視覺和文字資訊,並生成自然語言響應。通常使用預訓練的大語言模型,如 LLaMA、Vicuna、Qwen 等。
1.3 VLM 與純視覺模型、純語言模型的區別
| 模型型別 | 輸入 | 輸出 | 典型任務 | 代表模型 |
|---|---|---|---|---|
| 純視覺模型 | 影象 | 類別/檢測框 | 影象分類、目標檢測 | ResNet、ViT、YOLO |
| 純語言模型 | 文字 | 文字 | 文字生成、問答 | GPT、LLaMA、Qwen |
| 視覺語言模型 | 影象+文字 | 文字 | 影象描述、視覺問答、圖文檢索 | CLIP、BLIP、LLaVA |
VLM 的核心優勢在於跨模態理解能力:它不僅能識別影象中的物體,還能理解物體之間的關係、場景的語義資訊,並用自然語言表達出來。
二、VLM 的發展歷程:從萌芽到爆發
2.1 早期探索(2019-2020):雙塔結構的興起
VLM 的發展可以追溯到 2019-2020 年,這一時期的研究主要採用雙塔架構(Dual-stream Architecture),即分別用獨立的編碼器處理視覺和語言資訊,然後在共享空間中對齊。
代表性工作:
- ViLBERT(2019):將 BERT 架構擴充套件到視覺-語言領域,採用雙流架構分別處理影象和文字
- VisualBERT(2020):首個影象-文字預訓練模型,使用 Faster R-CNN 提取視覺特徵
- UNITER(2020):大規模視覺-語言預訓練,在多個下游任務上取得 SOTA
這些早期模型的共同特點是:
- 使用目標檢測器(如 Faster R-CNN)提取區域特徵
- 採用單流或雙流 Transformer 進行跨模態融合
- 預訓練任務主要包括掩碼語言建模(MLM)和影象-文字匹配(ITM)
2.2 CLIP 時代(2021):對比學習的革命
2021 年,OpenAI 發布了 CLIP(Contrastive Language-Image Pre-training),這是 VLM 發展史上的里程碑事件。
CLIP 的核心創新:
- 對比學習正規化:透過最大化匹配圖文對的相似度、最小化不匹配圖文對的相似度來學習跨模態表示
- 雙塔架構:影象編碼器和文字編碼器獨立工作,輸出對映到同一語義空間
- 大規模資料:使用 4 億個網際網路收集的影象-文字對進行訓練
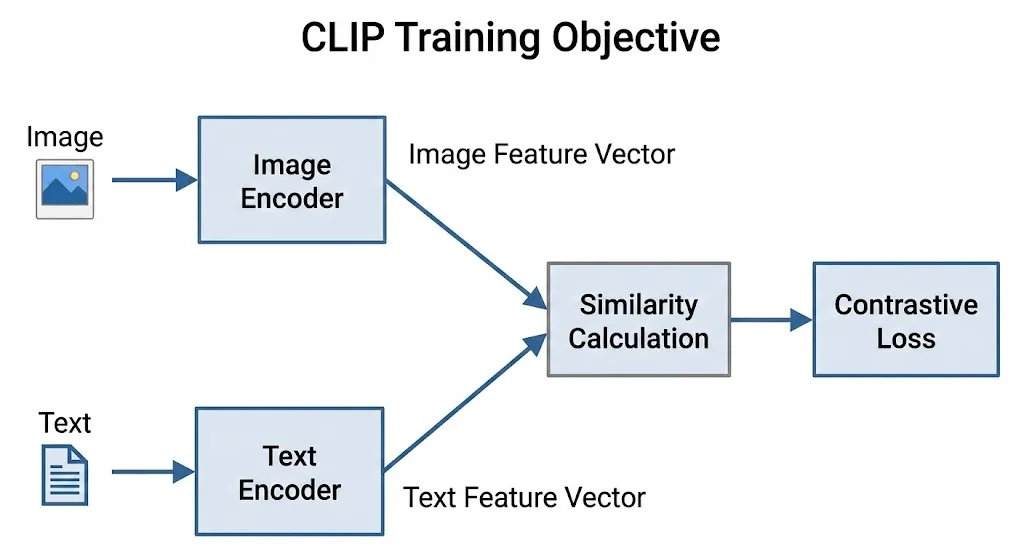
CLIP 的革命性意義在於:
- 零樣本能力:無需微調即可應用於下游任務
- 開放詞彙:不受預定義類別限制,可識別任意概念
- 強大的遷移能力:作為視覺編碼器廣泛應用於後續 VLM
同期,Google 發布了 ALIGN,採用類似的對比學習思路,但使用 18 億個噪聲更大的圖文對進行訓練,進一步驗證了規模的重要性。
2.3 統一框架(2022):理解與生成的一體化
2022 年,Salesforce 發布了 BLIP(Bootstrapping Language-Image Pre-training),提出了統一的視覺-語言理解與生成框架。
BLIP 的核心貢獻:
-
MED(Multimodal Mixture of Encoder-Decoder)架構:
- 單模態編碼器:分別編碼影象和文字
- 影象條件文字編碼器:融合視覺資訊進行理解
- 影象條件文字解碼器:生成影象描述
-
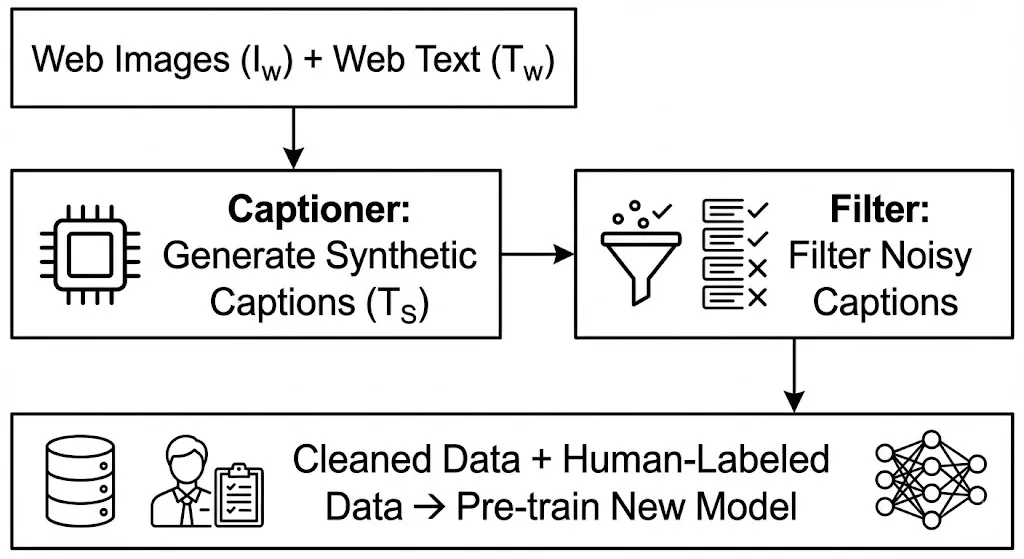
CapFilt(Captioning and Filtering):
- 使用”生成器+過濾器”策略清洗網路資料
- 生成器(Captioner)為網路影象生成合成描述
- 過濾器(Filter)去除噪聲描述
BLIP 在影象-文字檢索、影象描述、視覺問答等任務上取得了 SOTA 效能,並展示了強大的零樣本遷移能力。
2.4 大模型時代(2023):LLM 賦能的視覺助手
2023 年是 VLM 的爆發之年,核心趨勢是將預訓練的大語言模型(LLM)與視覺能力相結合。
代表性模型:
| 模型 | 機構 | 核心特點 | 發布時間 |
|---|---|---|---|
| BLIP-2 | Salesforce | 凍結視覺編碼器和 LLM,使用 Q-Former 橋接 | 2023.01 |
| LLaVA | 威斯康星大學 | 視覺指令微調,端到端訓練 | 2023.04 |
| MiniGPT-4 | KAUST | 單投影層對齊,兩階段訓練 | 2023.04 |
| Qwen-VL | 阿里巴巴 | 多語言、多影象、細粒度理解 | 2023.08 |
這一時期的共同特點:
- 凍結預訓練模型:視覺編碼器和 LLM 保持凍結,僅訓練介面卡,大幅降低訓練成本
- 指令微調:使用指令資料對模型進行微調,提升指令跟隨能力
- 端到端訓練:從視覺輸入直接生成文字輸出,簡化流程
以 LLaVA 為例,它首次將**視覺指令微調(Visual Instruction Tuning)**引入 VLM:
- 使用 GPT-4 生成多模態指令跟隨資料
- 將 CLIP 視覺編碼器與 Vicuna LLM 連線
- 端到端微調,實現強大的多模態對話能力
BLIP-2 則提出了兩階段訓練策略:
- 第一階段:使用凍結的視覺編碼器訓練 Q-Former 進行視覺-語言表示學習
- 第二階段:將 Q-Former 連線到凍結的 LLM,進行視覺到語言的生成學習
2.5 最新進展(2024-2025):多模態原生大模型
進入 2024-2025 年,VLM 朝著更大規模、更強能力、更多模態的方向發展。
主要趨勢:
- 模型規模擴大:從 7B 引數擴充套件到 70B+ 引數
- 解析度提升:支援更高解析度輸入(如 448×448、896×896)
- 多模態擴充套件:從影象-文字擴充套件到影片、音訊等多模態
- 原生多模態架構:不再簡單拼接單模態模型,而是從頭設計多模態架構
以 Qwen2-VL 為例,它引入了:
- 原生動態解析度支援,可處理任意解析度的影象
- 多模態旋轉位置編碼(M-RoPE),統一處理影象和影片
- 強大的文件理解和 OCR 能力
三、VLM 的核心技術原理
3.1 模型架構:單流 vs 雙流
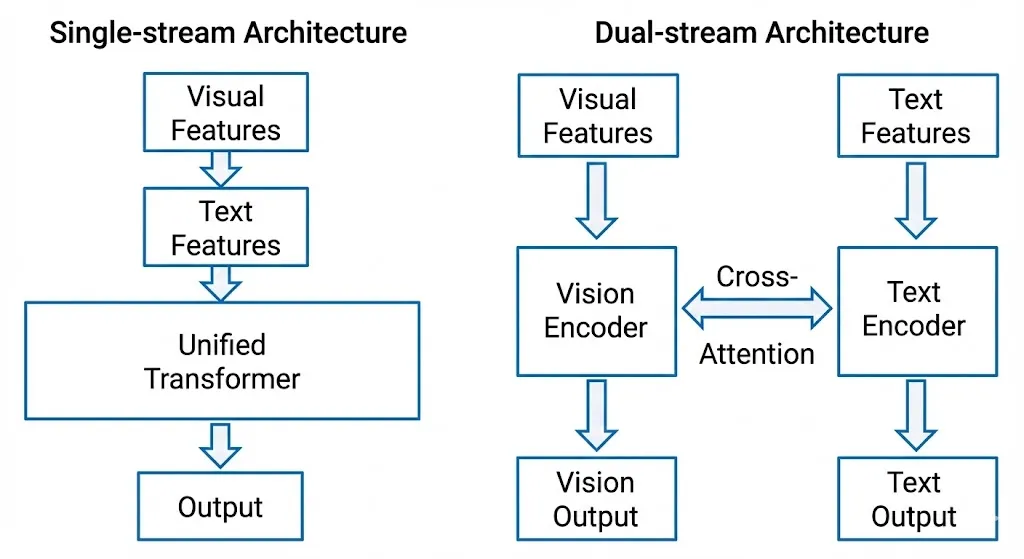
根據 VLP 綜述,VLM 的架構可以從兩個維度進行分類:
3.1.1 從多模態融合角度:單流 vs 雙流
單流架構(Single-stream):
- 將視覺特徵和文字特徵拼接後輸入單個 Transformer
- 使用統一的自注意力機制進行融合
- 引數效率更高,但模態間干擾較大
- 代表:VisualBERT、UNITER
雙流架構(Dual-stream):
- 視覺和文字分別輸入獨立的 Transformer
- 透過交叉注意力(Cross-Attention)實現跨模態互動
- 模態內資訊保留更好,但引數量更大
- 代表:CLIP、BLIP-2
3.1.2 從整體設計角度:Encoder-only vs Encoder-Decoder
Encoder-only:
- 僅使用編碼器提取跨模態表示
- 適用於理解任務(如圖文檢索、視覺問答)
- 代表:CLIP、ALBEF
Encoder-Decoder:
- 編碼器提取特徵,解碼器生成文字
- 適用於生成任務(如影象描述)
- 代表:BLIP、OFA
3.2 預訓練目標
VLM 的預訓練目標是學習視覺和語言之間的語義對應關係。根據 VLP 綜述,主要預訓練目標可以分為四類:
3.2.1 補全類(Completion)
掩碼語言建模(MLM):
- 隨機掩碼文字中的部分 token,讓模型根據視覺資訊和上下文預測
- 公式:
- 應用:VisualBERT、UNITER
掩碼視覺建模(MVM):
- 隨機掩碼部分影象區域,讓模型根據文字和其他視覺資訊預測
- 變體:掩碼特徵迴歸、掩碼特徵分類
- 應用:UNITER、OSCAR
3.2.2 匹配類(Matching)
影象-文字對比學習(ITC):
- 拉近匹配圖文對的特徵距離,推遠不匹配圖文對
- 使用 InfoNCE 損失函式
- 公式:
- 應用:CLIP、ALBEF、BLIP
影象-文字匹配(ITM):
- 二分類任務,判斷圖文對是否匹配
- 使用難負樣本挖掘策略
- 應用:ALBEF、BLIP
3.2.3 時序類(Temporal)
幀序建模(FOM):
- 打亂影片幀順序,讓模型預測正確順序
- 用於影片-語言預訓練
- 應用:VideoBERT
3.2.4 特定型別
視覺問答(VQA):
- 將 VQA 作為預訓練任務
- 分類或生成式答案預測
視覺描述(VC):
- 自迴歸生成影象描述
- 使用語言建模損失
3.3 視覺特徵提取的演進
VLM 中視覺特徵提取方式經歷了三代演進:
3.3.1 第一代:基於目標檢測的區域特徵(OD-RFs)
- 使用預訓練的目標檢測器(如 Faster R-CNN)提取區域特徵
- 每個區域特徵為 2048 維向量,附帶邊界框座標
- 優點:語義明確,包含物體級資訊
- 缺點:計算開銷大,只能提取有限數量的區域
- 代表:VisualBERT、UNITER、OSCAR
3.3.2 第二代:基於 CNN 的網格特徵(CNN-GFs)
- 使用 CNN(如 ResNet)提取網格特徵
- 可以端到端訓練
- 優點:計算效率更高
- 缺點:語義資訊不如區域特徵明確
- 代表:PixelBERT
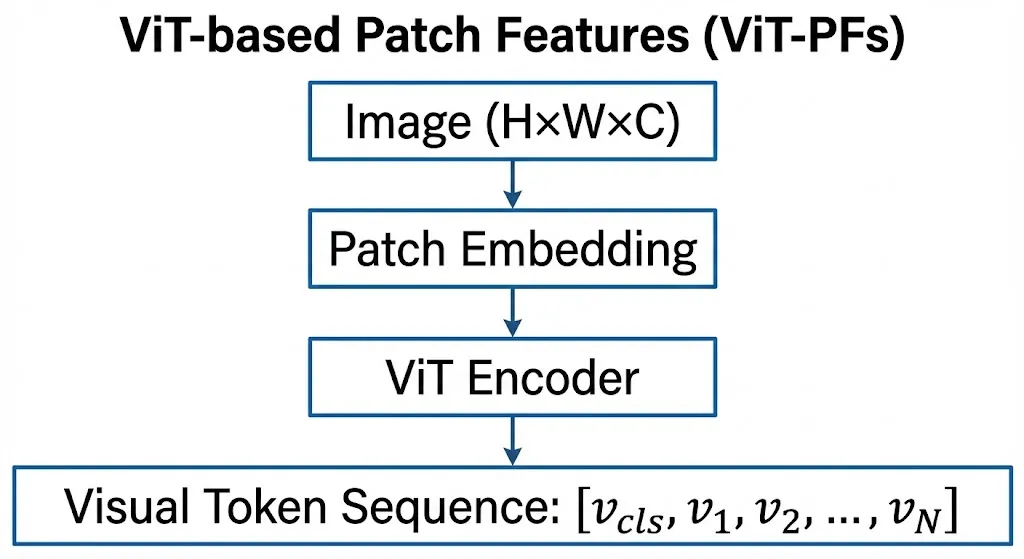
3.3.3 第三代:基於 ViT 的 Patch 特徵(ViT-PFs)
- 使用 Vision Transformer 將影象分割為 patch 序列
- 每個 patch 作為一個 token
- 優點:與 NLP 的 token 形式統一,便於跨模態融合
- 代表:CLIP、BLIP、LLaVA
3.4 訓練策略:兩階段 vs 三階段
現代 VLM 通常採用多階段訓練策略:
3.4.1 兩階段訓練(以 BLIP-2 為例)
第一階段:視覺-語言表示學習
- 凍結視覺編碼器
- 訓練 Q-Former 提取與文字最相關的視覺特徵
- 使用 ITC、ITM、ITG 三個目標
第二階段:視覺到語言生成學習
- 將 Q-Former 連線到凍結的 LLM
- 訓練 Q-Former 使輸出可被 LLM 理解
- 使用語言建模損失
3.4.2 三階段訓練(以 Qwen-VL 為例)
第一階段:預訓練
- 凍結 LLM,訓練視覺編碼器和介面卡
- 使用大規模圖文對資料(14 億對)
- 低解析度輸入(224×224)
第二階段:多工預訓練
- 解鎖 LLM,端到端訓練
- 引入高質量細粒度資料(VQA、OCR、Grounding 等)
- 高解析度輸入(448×448)
第三階段:監督微調
- 凍結視覺編碼器,微調 LLM 和介面卡
- 使用指令跟隨資料
- 增強對話能力和指令理解能力
四、主流 VLM 模型詳解
4.1 CLIP:跨模態對比學習的開創者
基本資訊:
- 發布時間:2021 年 2 月
- 機構:OpenAI
- 引數量:約 4 億引數(最大版本)
- 訓練資料:4 億圖文對
核心架構:
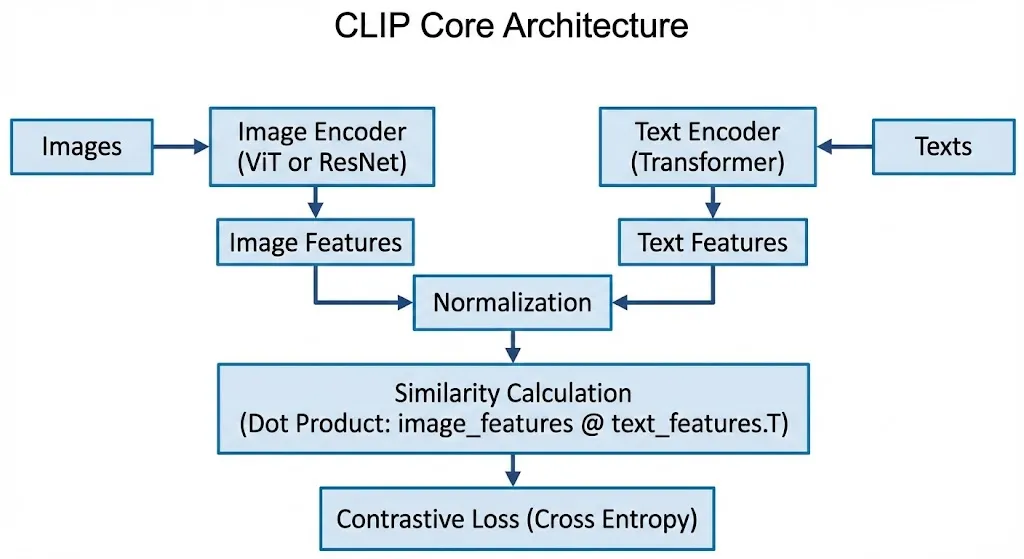
# CLIP 伪代码
image_features = image_encoder(images)  # ViT 或 ResNet
text_features = text_encoder(texts)      # Transformer

# 归一化
image_features = normalize(image_features)
text_features = normalize(text_features)

# 计算相似度
similarity = image_features @ text_features.T

# 对比损失
loss = cross_entropy_loss(similarity, labels)主要能力:
- 零樣本影象分類
- 影象-文字檢索
- 作為視覺編碼器用於下游任務
侷限性:
- 僅支援理解任務,不支援生成任務
- 對細粒度視覺理解能力有限
4.2 BLIP/BLIP-2:統一理解與生成
4.2.1 BLIP
核心創新:
- MED(多模態編解碼混合)架構
- CapFilt 資料自舉方法
CapFilt 流程:
4.2.2 BLIP-2
核心創新:
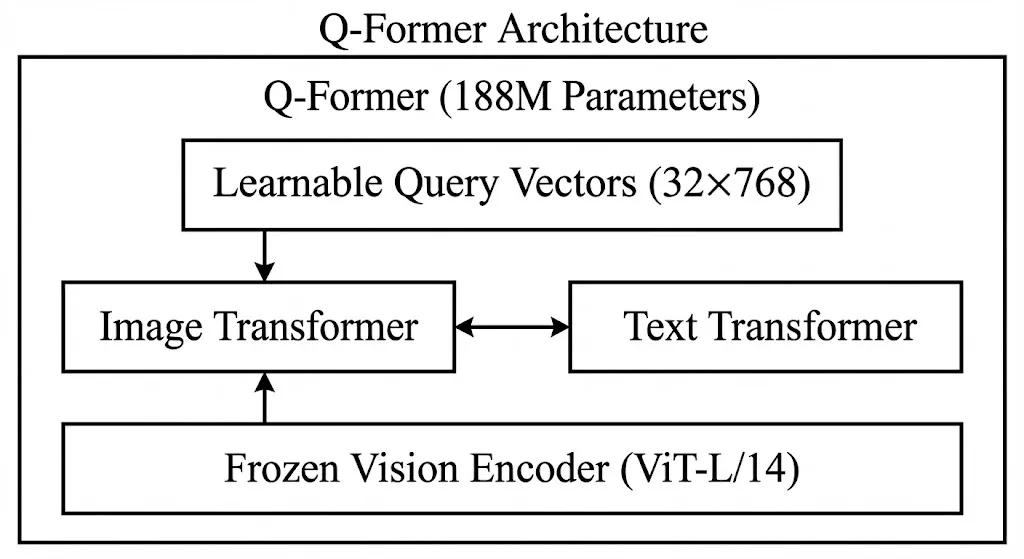
- Q-Former 架構:輕量級的查詢 Transformer
- 兩階段訓練策略
- 可插拔的凍結模型設計
Q-Former 架構:
效能表現:
- 在 VQAv2 上超過 Flamingo-80B 8.7%,但可訓練引數僅為其 1/54
4.3 LLaVA:視覺指令微調的先鋒
基本資訊:
- 發布時間:2023 年 4 月
- 機構:威斯康星大學麥迪遜分校
- 核心思想:將指令微調從 NLP 擴充套件到視覺-語言領域
資料生成:
- 使用 GPT-4 生成多模態指令跟隨資料
- 三種型別:對話、詳細描述、複雜推理
- 共 158K 樣本
架構:
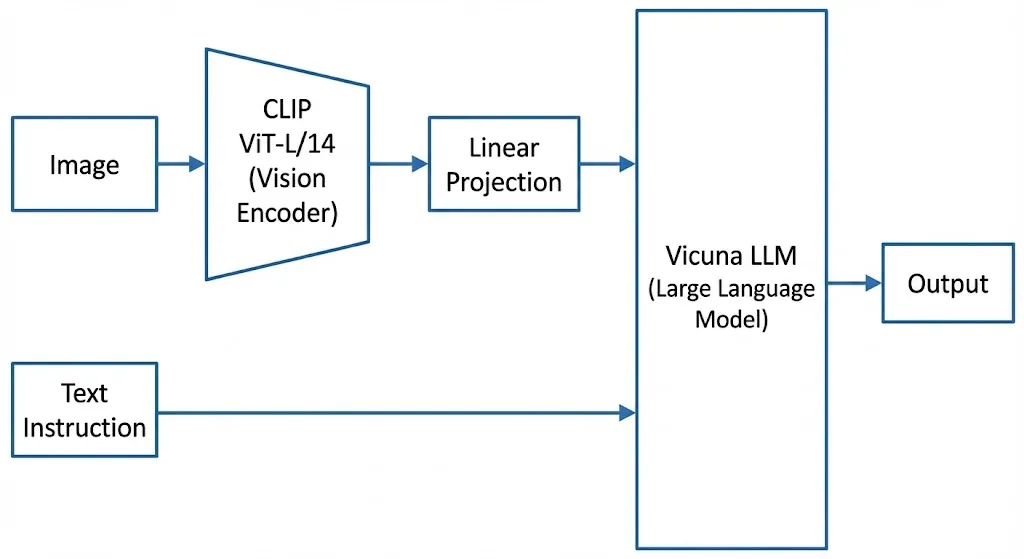
兩階段訓練:
-
特徵對齊預訓練:
- 凍結視覺編碼器和 LLM
- 僅訓練投影矩陣
- 使用 595K 圖文對
-
端到端微調:
- 凍結視覺編碼器
- 微調投影層和 LLM
- 使用 158K 指令資料
效能:
- 在 Science QA 上與 GPT-4 結合達到 92.53% 準確率(SOTA)
4.4 MiniGPT-4:極簡設計的強大能力
基本資訊:
- 發布時間:2023 年 4 月
- 機構:阿卜杜拉國王科技大學(KAUST)
架構:
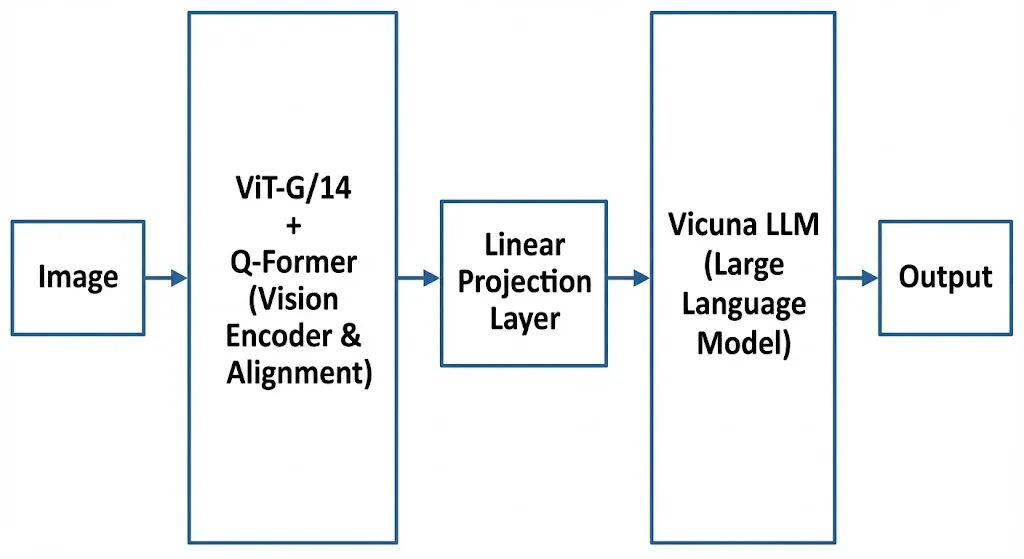
核心發現:
- 僅訓練一個線性投影層即可有效對齊視覺和語言
- 訓練僅需 4 張 A100 GPU,約 10 小時
兩階段訓練:
- 第一階段:使用大規模圖文對(500 萬對)進行預訓練
- 第二階段:使用 3500 個高質量詳細描述進行微調
湧現能力:
- 詳細影象描述
- 網站程式碼生成
- 詩歌創作
- 食譜生成
- 幽默解釋
4.5 Qwen-VL:多語言多影象的通用模型
基本資訊:
- 發布時間:2023 年 8 月
- 機構:阿里巴巴
- 基礎模型:Qwen-7B
核心特點:
-
多語言支援:
- 支援中英文雙語
- 訓練資料中 77.3% 英文,22.7% 中文
-
多影象輸入:
- 支援任意交錯的圖文資料
- 可比較、理解多張影象
-
細粒度理解:
- 高解析度輸入(448×448)
- 支援文字閱讀(OCR)
- 支援視覺定位(Grounding)
三階段訓練:
| 階段 | 資料 | 訓練策略 | 解析度 |
|---|---|---|---|
| 預訓練 | 14 億圖文對 | 凍結 LLM,訓練視覺模組 | 224×224 |
| 多工預訓練 | 7 個任務(76.8M 樣本) | 端到端訓練 | 448×448 |
| 監督微調 | 350K 指令資料 | 凍結視覺,微調 LLM | 448×448 |
效能表現:
- Flickr30K 影象描述:85.8 CIDEr(零樣本 SOTA)
- VQAv2:79.5% 準確率
- RefCOCO 定位:88.55% 準確率
五、VLM 的應用場景
5.1 影象描述與視覺問答
影象描述(Image Captioning):
- 為影象生成自然語言描述
- 應用:輔助視障人士、影象檢索、內容稽核
視覺問答(Visual Question Answering, VQA):
- 根據影象內容回答自然語言問題
- 應用:智慧客服、教育輔助、醫療影像分析
5.2 圖文檢索
影象-文字檢索:
- 文字到影象檢索:根據文字描述找到匹配影象
- 影象到文字檢索:根據影象找到相關文字描述
- 應用:搜尋引擎、電商平臺、內容推薦
5.3 文件理解
OCR 與文件分析:
- 文字閱讀:識別影象中的文字內容
- 表格理解:解析表格結構和內容
- 圖表分析:理解圖表中的資料和趨勢
- 應用:金融報告分析、合同審查、發票處理
5.4 視覺定位與指代表達
視覺定位(Visual Grounding):
- 根據文字描述定點陣圖像中的物體
- 輸出邊界框座標
指代表達理解(Referring Expression Comprehension):
- 理解如”左邊的紅衣服女孩”這樣的描述
- 應用:機器人導航、影象編輯、互動式 AI
5.5 創意生成
影象到程式碼:
- 將手繪草圖轉換為 HTML/CSS 程式碼
- 應用:前端開發、原型設計
影象到故事/詩歌:
- 根據影象創作故事或詩歌
- 應用:內容創作、教育娛樂
六、幻覺問題:VLM 的阿喀琉斯之踵
6.1 什麼是 VLM 幻覺?
根據《視覺語言大模型的幻覺綜述》,VLM 幻覺是指模型生成的文字響應表現出對影象內容的錯誤感知。
幻覺示例:
| 影象內容 | 模型輸出 | 問題 |
|---|---|---|
| 只有酸奶和草莓的冰箱 | “有草莓味酸奶” | 物體存在幻覺 |
| 限速 40km/h 的路牌 | “限速 60km/h” | 屬性幻覺 |
| 貓在沙發上 | “沙發上有一隻狗” | 物體識別錯誤 |
6.2 幻覺的分類
根據幻覺綜述,VLM 幻覺可分為三類:
-
物體存在幻覺(Object Existence Hallucination):
- 描述影象中不存在的物體
- 遺漏影象中存在的物體
-
物體屬性幻覺(Object Attribute Hallucination):
- 錯誤描述物體的顏色、形狀、材質等屬性
-
物體關係幻覺(Object Relationship Hallucination):
- 錯誤描述物體之間的空間位置關係
- 錯誤描述物體之間的互動關係
此外,研究還定義了其他型別的幻覺:
- 多模態衝突幻覺:文字輸入與視覺輸入不匹配時引發的幻覺
- 反常識幻覺:影象中存在反常識元素時導致的幻覺
- 事件幻覺:基於錯誤感知創造出完全虛構的事件或情景
- 數字幻覺:未能準確識別影象中特定物體的數量
6.3 幻覺的成因
幻覺綜述從四個維度分析了幻覺的成因:
6.3.1 訓練資料相關
-
影象的文字描述不夠細緻:
- 開源資料集中的文字描述較為粗糙
- 無法充分覆蓋影象內容
-
合成的指令微調資料存在噪聲:
- 使用 GPT-4 生成的指令資料可能包含幻覺元素
- 研究顯示 LLaVA 的 GPT-4 合成資料中約 32.6% 含有幻覺
-
資料中存在統計偏差:
- 物體類別出現頻率不均衡
- 正向響應比例過高
6.3.2 訓練任務相關
- 單一的語言建模任務缺乏對模態間一致性的顯式約束
- 模型過於關注生成文字的流暢性,而忽略與視覺資訊的一致性
6.3.3 視覺編碼相關
-
細粒度視覺資訊感知能力不足:
- 輸入解析度通常低於 400 像素
- 訓練資料中的文字標註只能涵蓋主要內容而非細節
-
視覺特徵無法受到 LLM 的充分關注:
- 視覺 token 在 LLM 中的平均注意力分數不足 20%
- 隨著生成進行,對視覺 token 的關注持續下降
6.3.4 文字生成相關
-
LLM 的先驗性知識偏差:
- 模型傾向於依賴先驗知識而非實際視覺證據
- 即使輸入噪聲影象,仍可能輸出高置信度答案
-
自迴歸解碼中的偏差累積:
- 早期生成的小錯誤會在後續生成中被放大
- 幻覺頻率隨生成長度增加而升高
-
固有的取樣隨機性:
- 取樣過程可能導致模型偶爾輸出機率較低的錯誤 token
6.4 幻覺的評估
幻覺評估基準包括:
| 基準 | 任務形式 | 評估指標 | 幻覺型別 |
|---|---|---|---|
| CHAIR | 影象描述 | CHAIRi, CHAIRs | 物體存在 |
| POPE | 視覺問答 | 準確率、F1 | 物體存在 |
| MME | 視覺問答 | Accuracy+ | 存在、屬性 |
| AMBER | 描述+問答 | 準確率、精確率、召回率 | 存在、屬性、關係 |
| MMHAL-BENCH | 描述+問答 | GPT-4 評分 | 多種型別 |
6.5 幻覺的治理
幻覺綜述從五個維度討論了幻覺治理策略:
6.5.1 資料側
- 提升指令資料的多樣性
- 增強影象-文字關聯度
- 使用高質量的人工標註資料
6.5.2 視覺感知側
- 使用更高解析度的視覺編碼器
- 整合多個視覺編碼器
- 增加視覺編碼器的引數規模
6.5.3 訓練策略側
- 引入新的監督訊號
- 使用強化學習
- 增加任務資訊
6.5.4 推理側
- 對比解碼
- 不確定性估計
- 多步推理
6.5.5 事後修正側
- 使用外部知識驗證
- 自我修正機制
- 人類反饋
七、VLM 的技術挑戰與未來方向
7.1 當前挑戰
7.1.1 幻覺問題
- 如前所述,幻覺是限制 VLM 在高風險領域應用的主要因素
- 需要更可靠的評估和治理方法
7.1.2 細粒度理解
- 當前 VLM 對細節的理解能力仍有限
- 高解析度處理需要更多計算資源
7.1.3 多模態融合
- 如何更好地融合視覺、語言、音訊等多種模態
- 如何處理模態間的資訊衝突
7.1.4 計算效率
- 大規模 VLM 的推理成本高昂
- 需要更高效的模型壓縮和加速技術
7.2 未來方向
7.2.1 原生多模態架構
- 從頭設計支援多模態的架構,而非簡單拼接單模態模型
- 統一處理文字、影象、影片、音訊等多種模態
7.2.2 世界模型
- 構建能夠理解物理世界的 VLM
- 支援因果推理和物理模擬
7.2.3 具身智慧
- 將 VLM 與機器人結合
- 支援視覺導航、物體操作等任務
7.2.4 個性化與可解釋性
- 支援使用者個性化的 VLM
- 提供可解釋的推理過程
八、總結
視覺語言模型(VLM)代表了人工智慧領域的重要進展,它讓機器能夠同時”看懂”影象和”理解”語言,開啟了人機互動的全新正規化。
從發展歷程看:
- 從早期的雙塔架構到 CLIP 的對比學習革命
- 從 BLIP 的統一框架到 LLM 賦能的視覺助手
- VLM 正在朝著更大規模、更強能力、更多模態的方向發展
從技術原理看:
- VLM 的核心在於跨模態對齊和融合
- 預訓練目標、模型架構、訓練策略都在不斷演進
- 幻覺問題仍是當前的主要挑戰
從應用場景看:
- 影象描述、視覺問答、圖文檢索等基礎任務已較為成熟
- 文件理解、視覺定位、創意生成等高階任務正在快速發展
- 未來將在更多領域發揮重要作用
對於初學者,理解 VLM 的關鍵在於把握跨模態對齊這一核心思想;對於技術從業者,則需要深入理解各種架構設計和訓練策略的優劣。無論如何,VLM 都是一個值得持續關注的領域,它正在重新定義人機互動的方式,讓我們離真正的通用人工智慧更近一步。
參考資料
[2]: VLM 說明
[3]: VLP: A Survey on Vision-Language Pre-training
[4]: Learning Transferable Visual Models From Natural Language Supervision (CLIP)
[5]: Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision (ALIGN)
[7]: Visual Instruction Tuning (LLaVA)
[9]: Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution
延伸閱讀:
- Guide to Vision-Language Models (VLMs) | Encord
- 視覺語言模型詳解 | Hugging Face
- What Are Vision Language Models | NVIDIA
參考資料與閱讀順序
先從原始論文看結構,再對照具體模型卡和程式碼,比較容易區分方法本身與某個版本的能力。
- CLIP:Learning Transferable Visual Models From Natural Language Supervision:對照前文雙塔結構與圖文對齊部分。
- BLIP-2:看凍結視覺編碼器與語言模型之間如何連線。
- LLaVA:Visual Instruction Tuning:看視覺指令資料和多模態對話訓練。
- Qwen3-VL 技術報告:結合較新的模型家族看視覺理解與訓練設計。
- Qwen3-VL-2B-Instruct 模型卡:部署時核對依賴、輸入處理和對應版本。
本文裡的演示對話用於解釋任務,不是固定模型的實測結果。論文效能、官方能力描述和本地執行結果需要分別記錄;要實際跑一個小模型,可以從本地模型記錄開始。