A computer program is said to learn from experience E with respect to some task T and some performance measure P, if its performance on T, as measured by P, improves with experience E.
基礎概念
近些年,人工智慧飛速發展,我們經常聽到人工智慧、機器學習、深度學習和強化學習等名詞。事實上,它們之間存在著密切的聯絡。
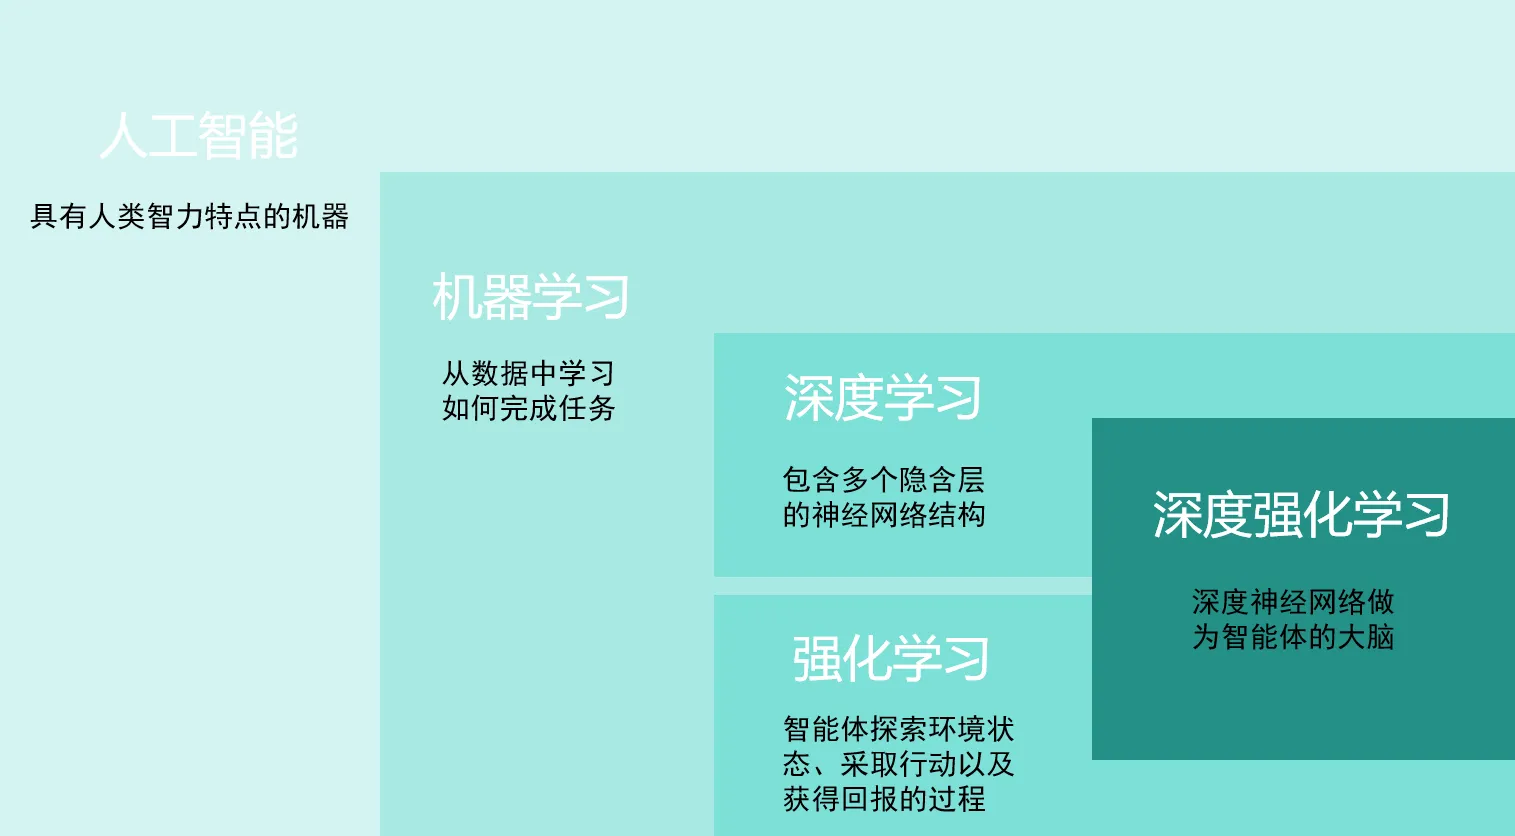
人工智慧
人工智慧(Artificial Intelligence, AI)是一個廣泛的領域,可以從“能力”和“學科”兩個方面對人工智慧進行定義。從能力的角度看,人工智慧是指用人工的方法在機器上實現的智慧;從學科角度看,人工智慧是一門研究如何構造智慧機器或智慧系統,使其能模擬、延伸和擴充套件人類智慧的學科。
機器學習
機器學習(Machine Learning, ML)是AI的一個子集,它專注於開發演算法和統計模型。機器學習是指在不需要明確程式設計的情況下,讓計算機能夠利用資料提高在某個任務上表現的演算法。機器學習又可以分為監督學習、無監督學習、半監督學習和強化學習等。
深度學習
深度學習(Deep Learning, DL)是機器學習的一個子領域,它使用類似於人腦的神經網路結構,特別是具有多個層的深層神經網路,來學習複雜的模式和表示。
強化學習
強化學習(Reinforcement Learning, RL)是機器學習的一個分支,它專注於如何讓智慧體(agent)透過與環境的互動來學習最佳行為或策略,以最大化某種累積獎勵。
深度強化學習
深度強化學習(Deep Reinforcement Learning, DRL)是深度學習和強化學習的結合,它使用深度神經網路作為智慧體的大腦,以處理高維度的輸入資料並學習複雜的策略。
它們的關係可以大致總結為下圖:
課程基礎
機器學習
機器學習最重要的是尋找到一個函式,讓機器具備找到一個函式的能力。
通常情況下,函式是非常複雜的,人難以自己寫出,若是透過機器的力量自己找出有很多優勢。
機器學習尋找的函式通常是不同的,根據實際需求可以分成迴歸、分類和結構化學習等。
迴歸(regression)
假設要找的函式輸出的是一個數值,或者稱為一個標量(scalar),這種機器學習的任務稱為迴歸。(根據歷史資料和指標預測未來的一個數值)
迴歸問題中,比較經典的是房價預測問題,這個問題在很多教程中都被作為例子,在Kaggle中可以進行實踐。
分類(classification)
分類任務是讓機器做選擇題,函式的輸出是從設定好的選項中選出一個選項當作輸出。通常,在確定選項的過程中會牽扯到機率的計算,根據機率判斷最可能的選項,常見的分類演算法中都有機率的影子,個人感覺人工智慧技術的發展確實離不開數學的支援。
在分類問題中,比較常見的就是垃圾郵件判斷的例子,判斷郵件是否為垃圾郵件,這是一個二分類問題,除此之外還有多分類,AlphaGo下圍棋就是從棋盤中找到最正確的選項,還有動物識別(貓、狗、鳥……)。
結構化學習(structed learning)
在這種情況下,機器學習並不只是要做出選擇或者輸出一個數字,而是要產生一個有結構的物體,比如畫一張圖、寫一篇文章……近些年也逐漸得到更多應用。
在其他學習群裡看到過一張有意思的圖:
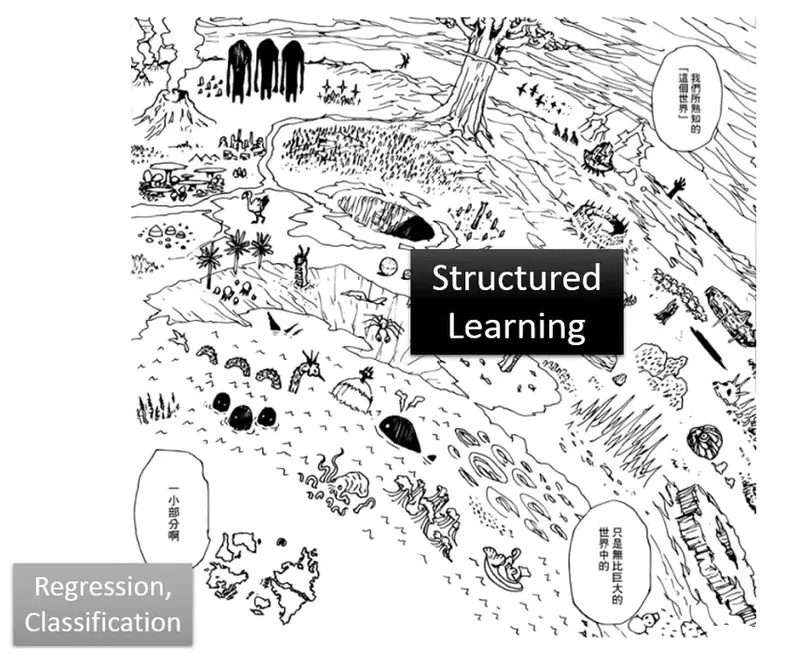
結構化學習仍需要我們去探索。
案例學習
已有的資料是youtube後以往的資訊,想要得到的明天可能觀看的次數是多少 透過一個函式來實現這個過程
機器學習找函式的過程
1、寫出一個帶有未知引數的函式(這個函式基於我們的知識積累設定,這只是一個猜測),這個函式能夠預測未來觀看的次數
其中表示要預測的觀看次數, 表示前一天的觀看人數
和都表示未知的引數,都需要讓機器從資料中學習
2、定義損失函式(loss function)
損失函式就是:在當前引數組合下,所有資料誤差和的平均值(個人理解),公式如下:
其中表示誤差
可以採用預測值與目標值之間差的絕對值:
也可以採用差的平方:
當採用絕對值,稱為MAE(Mean Absolute Error)
當採用平方,稱為MSE(Mean Squared Error)
除了上述的兩種方式,還有一種計算loss的方式稱為“交叉熵”
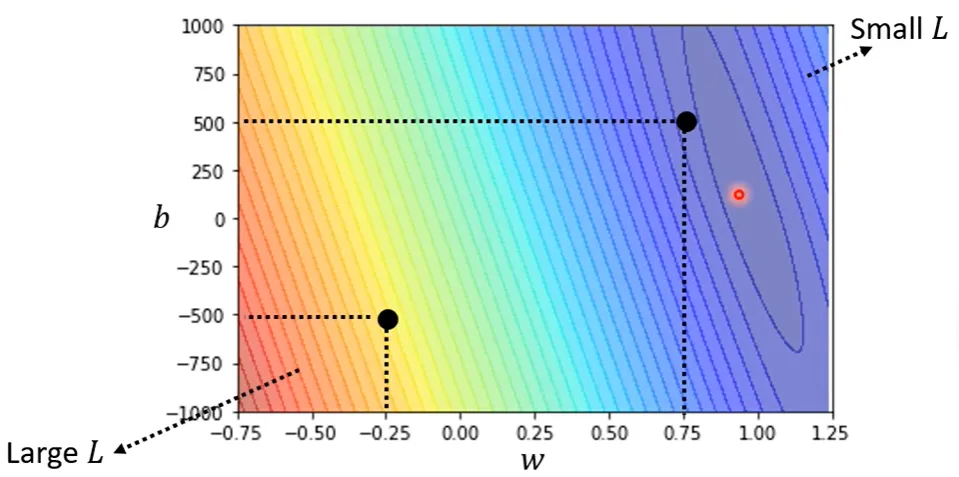
計算的損失函式可以透過視覺化方式呈現,如:熱力圖、等高線圖……。下面是課程中採用的示例:
3、最佳化(Optimization)
最佳化的目的是讓損失函式的值最小,如下公式:
我們要找到讓損失函式值最小的未知引數組合。
常用的方式是梯度下降(gradient descent),透過梯度下降進行引數最佳化的過程如圖:
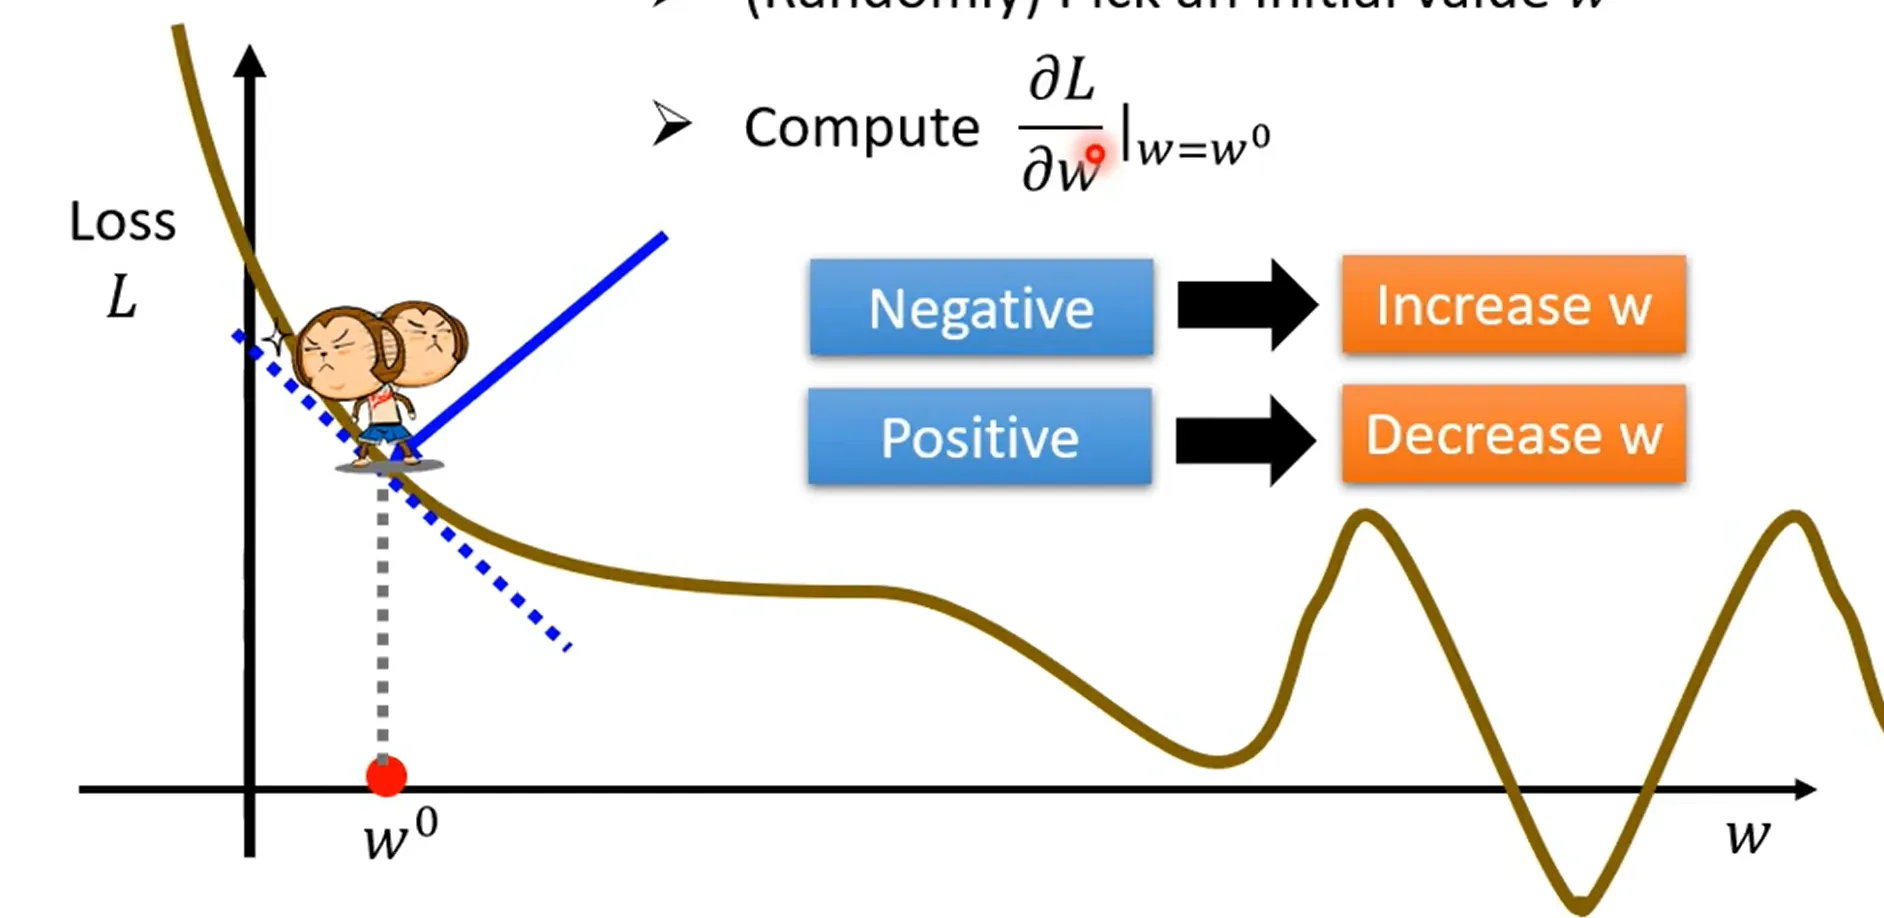
其中有幾個非常重要的概念:
斜率:斜率大於0表示loss在上升,斜率小於0表示loss在下降,等於0表示到達了一個極值點。
學習率(learning rate):可以理解為跨一步的大小,越高,跨一步越大,反之越小。可以經驗決定。
超引數(hyperparameter):在機器學習過程中需要人為預先設定的引數。
還有一個重要的點是關於的更新:
隨著的不斷更新,理想狀態下loss的斜率會成為0,如下圖所示
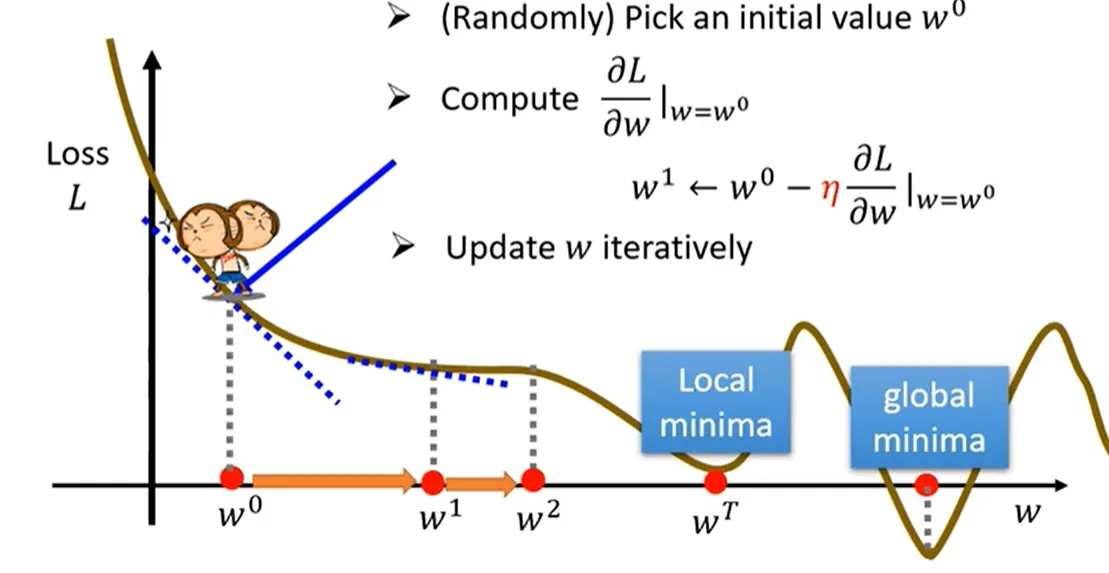
當時,斜率為0,當時此時loss並不是最低的
local minima:區域性最小
global minima:全域性最小
在上圖中,一個有意的現象,loss有負值,為什麼loss可以是負的?
因為loss是可以自己定義的,用上邊的絕對值和平方計算肯定是正值,但是如果自己定義不同的方式可以是負值。
4、最後
找到合適的模型要觀察資料、理解資料並進行試驗,根據結果更新模型。