BackdoorIndicator: Leveraging OOD Data for Proactive Backdoor Detection in Federated Learning
BackdoorIndicator:分布外(OOD)データを用いた、連合学習における能動的なバックドア検出。
USENIX Security 2024:arXiv
東南大学の Songze Li、香港科技大学(広州)の Yanbo Dai。
はじめに
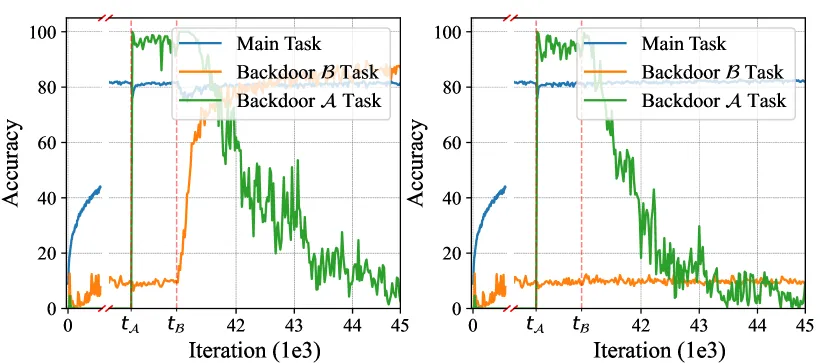
同じターゲットラベルを持つ異なるバックドアタスクを順に埋め込むと、後から埋め込んだバックドアが、先に埋め込んだものの精度を維持することがあります。単に上書きしたり消したりするわけではありません。バックドアを分布外(OOD、out-of-distribution)のタスクと捉えると、埋め込みとは、通常の分布内(ID)の対応関係をなるべく壊さずに、OOD 特徴、つまりトリガーからターゲットラベルへの隠れた対応関係を追加することだと考えられます。
同じターゲットに向かう OOD の対応関係には、共通する性質があります。
バックドア A と B が同じターゲットラベルを持つとします。
A の埋め込みを止め、B も追加しない場合、モデルは正常なデータだけで学習します。通常の ID の対応関係は強化されますが、A に対応する OOD の関係は徐々に忘れられていきます。
A の埋め込みを止める一方で B を埋め込み始めると、トリガーは変わっても、モデルは何らかの OOD 特徴と同じターゲットラベルの対応を維持しなければなりません。その能力の一部が保持されます。
A と B は、正常なデータに対して OOD であるという特徴を共有しています。B の学習はモデルの OOD 特徴への感度を維持し、結果として A の対応関係も通常の学習による忘却から守ることがあります。
この観察から、能動的な防御が提案されています。サーバーはモデルを配布する前に、OOD データを用いた**指標タスク(indicator task)**を埋め込みます。悪意のあるクライアントが自分のバックドアを学習すると、その過程で指標タスクの精度も維持されます。一方、正常なクライアントはそれを忘れる傾向があります。サーバーはこの違いを調べ、疑わしい更新を検出します。
狙いは、低い汚染学習率や非 IID なデータ分布のもとで、ノルムクリッピングや距離に基づくクラスタリングなどの受動的防御が効きにくくなる問題です。論文は、信頼できる正常なルートデータを必要とせず、評価した条件で高い検出性能を報告しています。ただし、あらゆる攻撃に対する保証ではありません。
- TPR(True Positive Rate、真陽性率):正しく検出した悪意のある更新数を、悪意のある更新の総数で割った値です。高いほど多くの攻撃を検出できます。
- FPR(False Positive Rate、偽陽性率):悪意があると誤判定した正常な更新数を、正常な更新の総数で割った値です。低いほど正常なクライアントの誤排除が少なくなります。
- BA(Backdoor Accuracy、バックドア精度):攻撃者が汚染を止めた後の、グローバルモデルのバックドアタスク精度です。防御側から見れば低いほうがよく、バックドアの効果が残っていないことを示します。
背景
連合学習では、悪意のあるクライアントが汚染したローカルモデルをアップロードし、グローバルモデルにバックドアを埋め込めます。特定のトリガーが現れたときだけ誤分類が起こるため、見つけにくい攻撃です。
従来の主な防御は受動的です。アップロードされたパラメータのユークリッド距離、コサイン類似度、L2 ノルムなどの統計的特徴を調べます。
難しさは、主に次の二つです。
- 統計的特徴を似せられること。 攻撃の学習率が小さい場合や、クライアントのデータが強く非 IID である場合、悪意のある更新が正常な更新に近くなります。
- 性能が条件に左右されること。 FLAME などでは、評価条件によって攻撃が目立たなくなると、TPR が 0 まで下がる場合があります。
論文の新しい点
同じターゲットラベルを持つ二つのバックドアタスクを順に埋め込むと、トリガーが違っても後のタスクが前のタスクの精度を維持する、という観察が出発点です。この効果を評価するときは、バッチ正規化(BN)の統計量のずれを補正する必要があります。
そのまま測定すると、B を追加した後も A の精度が落ちたように見えることがあります。学習データが変わると、BN が推定する平均と分散も変わるからです。評価時に適切な保存済みの BN 統計量を戻すと、このずれを取り除き、前のタスクが保持されていることを確認できます。
正常なタスクは ID 特徴を学びます。一方、バックドアタスクは通常 OOD である入力とターゲットラベルの対応を作ります。
- 正常なクライアント:ID データの学習によって OOD タスクを忘れ、指標の精度が下がることがあります。
- 悪意のあるクライアント:バックドアを埋め込むには OOD の対応関係を維持する必要があるため、サーバーが埋め込んだ指標タスクも保護してしまうことがあります。
BN について補足します。バッチ正規化は学習の安定化と高速化に用いられ、学習時には現在のバッチの経験平均と分散を、推論時には学習中に蓄積した移動統計量を使います。
学習データが A から B に変わると、移動平均と分散が A の評価に適した分布からずれていきます。新しい統計量で A を測ると、実際の保持能力が見えにくくなります。この論文では、指標を評価する際にその影響を補正します。
BackdoorIndicator の仕組み
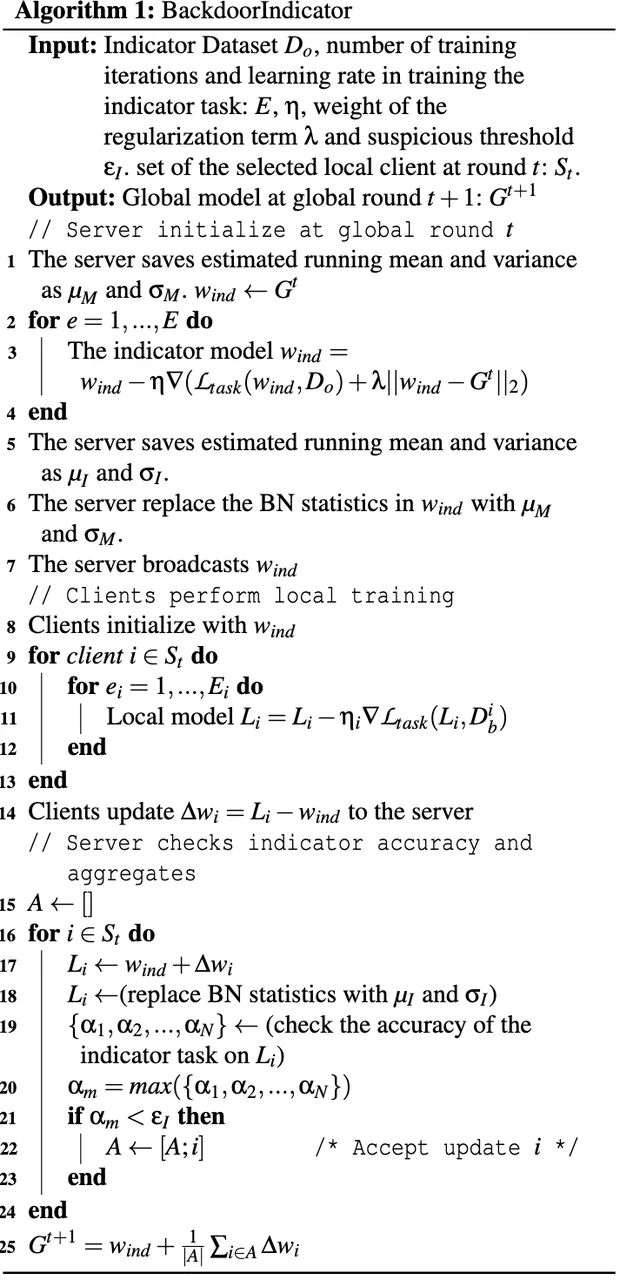
入力
- 指標データセット:OOD データからなる 。
- 指標タスクの学習設定:反復回数 と学習率 。
- 正則化の重み:。指標タスクが主タスクに与える影響を抑えます。
- 疑いを判定するしきい値:。疑わしいモデルの除外に使います。
- 参加クライアント:ラウンド で無作為に選んだ集合 。
出力
- 次のグローバルモデル:フィルタリングと集約を経て得られる 。
第1段階:サーバーの初期化と指標の埋め込み
サーバーは、配布するモデルに指標タスクを埋め込みます。
- 元の統計量を保存する。 現在のグローバルモデル の BN の平均と分散を、 と として保存します。 と初期化します。
- 指標タスクを学習する。 で 回反復します。交差エントロピーに加え、L2 正則化項 を使って、主タスクからの過度なずれを抑えます。
- 指標用の統計量を保存する。 学習後の BN の平均と分散を、 と として記録します。
- 元の統計量に戻す。 主タスクの精度への影響を減らすため、 の BN 統計量を、保存した と に置き換えます。
- モデルを配布する。 選ばれたクライアント に を送ります。
第2段階:クライアントでのローカル学習
クライアントは通常の連合学習の更新を行います。
- 初期化する。 受け取った をローカルモデルの初期状態にします。
- 非公開データで学習する。 各クライアントが自分の非公開データセットで勾配に基づく学習を行い、 を得ます。
- 差分をアップロードする。 を計算し、その更新をサーバーに送ります。
第3段階:サーバーでの検出と集約
サーバーは BN のずれを補正し、指標タスクを評価して疑わしいモデルを除外します。
- 受理するクライアントの集合を用意する。 空の集合 を初期化します。
- BN のずれを補正する。 各更新から を復元し、BN 統計量を と に置き換えます。
- 指標の精度を測る。 の各ラベルに対する精度を評価し、 を得ます。
- 最大値を取る。 最大のクラス別精度を とし、指標タスクをどれほど保持しているかを見ます。
- しきい値で判定する。
- なら、指標を十分に忘れた正常な更新と判定し、クライアントを に加えます。
- なら、OOD の対応を保持したバックドアの疑いがある更新と判定し、 に加えません。
- 受理した更新を集約する。 次のグローバルモデルは です。
サーバーは、バックドアの種類、トリガー、ターゲットラベルを事前には知りません。そこで著者らは、指標を埋め込む段階でラベルをカバーし、検出時にはクラス別に測った精度の最大値を使います。
これにより、攻撃者のターゲットラベルを先に推測する必要がなくなります。ただし、検出結果は OOD データ、学習設定、しきい値に依存します。論文の実験が支持する方法であって、どのバックドアにも無条件で効くわけではありません。
実験結果
著者らは CIFAR10、CIFAR100、EMNIST などで、ピクセルパターン、意味的なトリガー、エッジケースなどのバックドアと、PGD、Neurotoxin、Chameleon などの攻撃手法を評価しています。
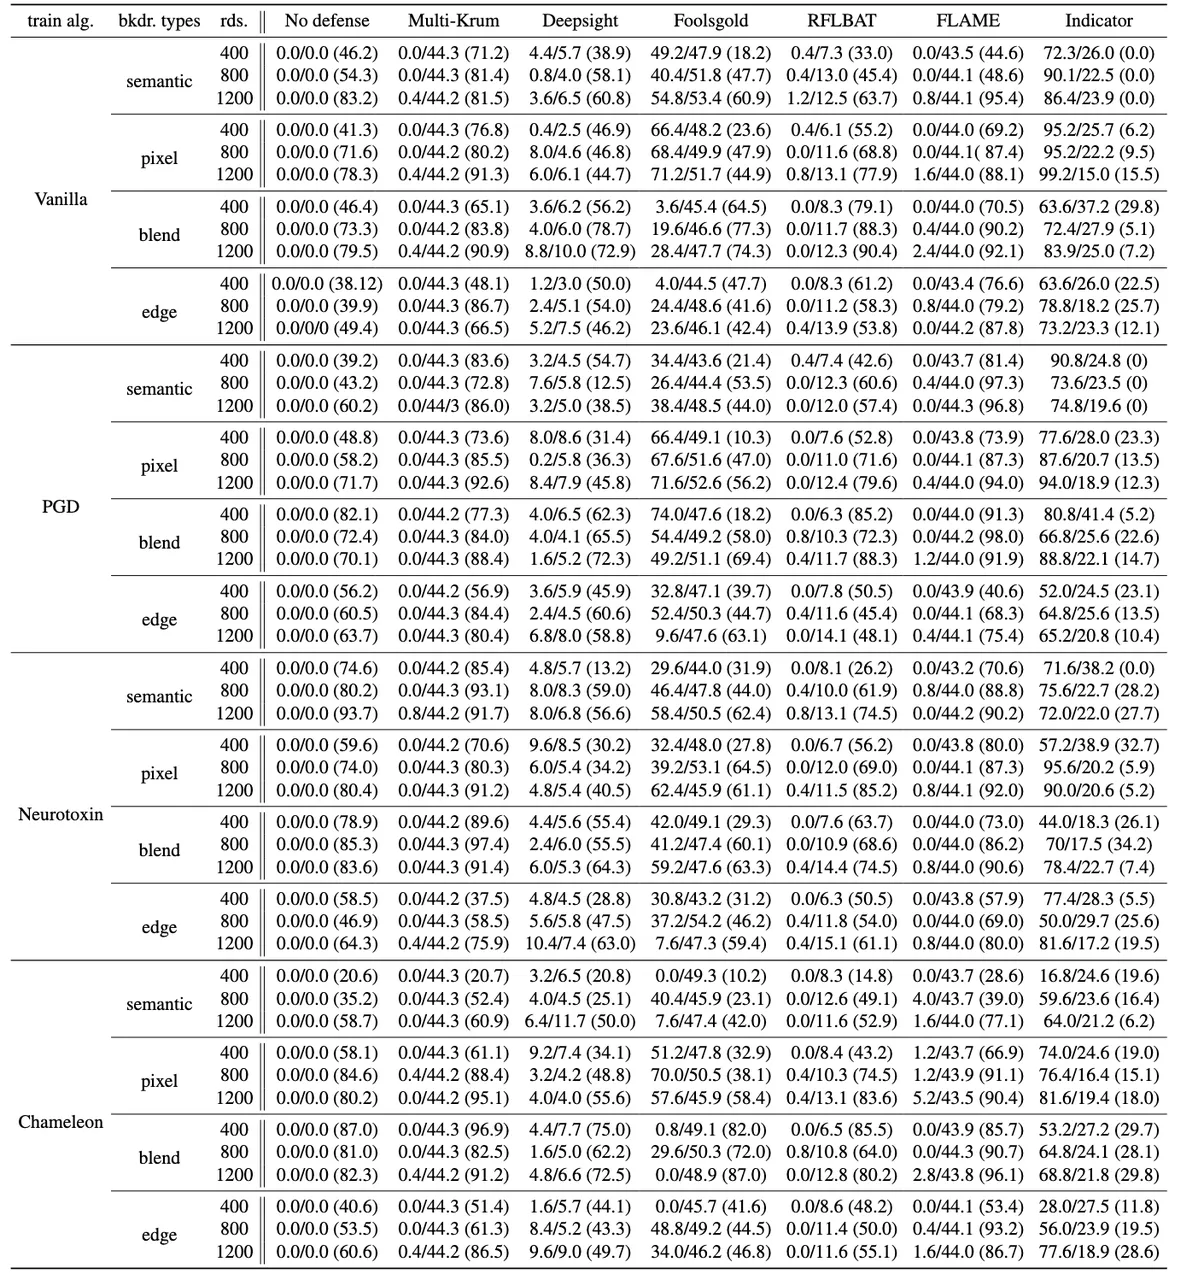
例えば、論文の表4にある CIFAR10 の単一クライアントによる Vanilla のピクセルバックドア実験では、非 IID パラメータ α=0.2、悪意のあるクライアントの学習率 0.01 の条件で、FLAME の TPR は 0%、BackdoorIndicator は 98.0% です。一方、後者の FPR は 19.7% あります。検出率が高いからといって、誤検出を無視できるとはいえません。すべてのタスクや攻撃条件への一般化もできません。
下の画像は表2で、別の比較条件です。上の学習率 0.01 の数字は表4に由来するため、区別して読む必要があります。
悪意のある学習アルゴリズム
- Vanilla:汚染データと正常なデータを混ぜ、交差エントロピーで学習する基本的なバックドア攻撃です。
- PGD(Projected Gradient Descent):学習中のパラメータの変化を制約し、大きな更新ノルムを検出する防御を回避しようとします。
- Neurotoxin:正常なクライアントがあまり更新しないパラメータ領域を狙い、後の正常な学習で消えにくいバックドアを埋め込みます。
- Chameleon:教師あり対照学習を用いて、潜在空間でバックドア特徴と正常な特徴の関係を調整し、隠れやすさと持続性を高めます。
バックドアのトリガーの種類
- Semantic:人工的なピクセルパッチではなく、自然な特徴を使います。例えば、背景の壁に縦縞があると車を誤分類する、といったものです。
- Pixel:画像の決まった場所に、特定のピクセルや小さなパターンを置きます。
- Blend:通常の画像にノイズパターンを一定の透明度で混ぜ、目で気づきにくくします。
- Edge:入力分布のロングテールにあるデータを汚染します。典型的な正常データとの重なりが小さいケースを利用します。
比較する防御手法
- Multi-Krum:更新間のユークリッド距離に基づくビザンチン耐性のある集約手法で、外れた更新を除外しようとします。
- DeepSight:ニューロンの出力分布や予測スコアなど、モデルの細かい挙動を調べ、クラスタリングによって異常を探します。
- FoolsGold:正常なクライアントのデータは多様だが、共謀する攻撃者の目標は共通するという仮定のもと、過去の更新のコサイン類似度を使って、似すぎた挙動の重みを下げます。
- RFLBAT:PCA で次元を減らし、クラスタリングとユークリッド距離によって異常な更新を特定します。
- FLAME:クラスタリング、ノルムクリッピング、ガウスノイズを組み合わせ、残るバックドアの影響を抑えます。
自分なりの考察
統計的に違う更新を探す受動的な検出から、学習挙動の違いを引き出すタスクを先に仕込む能動的な検出への転換です。
パラメータ分布の仮定だけに頼るのではなく、OOD への汎化と忘却という性質を利用しています。
実験は画像分類が対象です。自分たちはマルチモーダルに関心があるので、マルチモーダル学習・連合学習・バックドア攻撃をどう結び付けられるか、という問いにつながります。
オープンソース実装の再現準備
以下は著者のコードを確認して整理した準備手順です。自分の再現実験結果はまだ追加していません。上の数値も、引き続き著者の実験結果です。
1. コードと環境を固定する
公式実装は ybdai7/Backdoor-indicator-defense です。README の参考環境は Python 3.7.15、PyTorch 1.13.0、torchvision 0.14.0 です。他のモデルの環境に依存関係を混ぜず、独立した環境を作り、CUDA と PyTorch の組み合わせを確認します。
git clone https://github.com/ybdai7/Backdoor-indicator-defense.git
cd Backdoor-indicator-defense
git rev-parse HEAD
python -m pip install -r requirement.txt
出力されたコミット ID と、実際に解決された依存関係のバージョンを保存します。ファイル名は単数形の requirement.txt で、一般的な requirements.txt ではありません。
2. データと実験設定を確認する
まず論文の実験条件を一つ選びます。ID/OOD データ、モデル、クライアント数、データ分割、学習ラウンド数を確認します。最初から多くの設定を同時に変えると、違いの原因が分からなくなります。
著者の指標用設定ファイルには、モデル、データソース、学習段階の設定が含まれます。起動前に少なくとも dataset、ood_data_source、resumed_model、二つの段階の開始ラウンドを確認します。チェックポイントから再開するかどうかも、比較する実験でそろえます。
3. 指標を使う前にベースラインを動かす
上流の手順では、まず基礎モデルを学習してチェックポイントを保存し、そのチェックポイントから防御手法を比較します。最初に確認するのは、高い検出率が出るかではなく、正常な学習と評価が動くこと、保存したモデルと復元したモデルが一致することです。
依存関係、データ、設定を確認したら、次のコマンドを使います。
python main.py --GPU_id 0 --params utils/yamls/indicator/params_vanilla_Indicator.yaml引数の大文字・小文字やパスは、実際のエントリーポイントに合わせます。出力先は saved_models です。各実験の設定、依存関係、ログを残し、最後の数字だけを保存しないようにします。
4. どの指標を比較するか
主タスクの精度、バックドア攻撃の成功率、TPR/FPR、追加の学習コストを分けて記録します。データ分割、クライアントのサンプリング、乱数シード、攻撃条件、比較したラウンドも記録します。
検出率が高くても、正常なクライアントを大量に誤排除するなら、そのまま優れた防御とはいえません。OOD データの量、しきい値、クライアント分布を一つずつ変え、結果が安定するかを調べます。
適用範囲をもう少し考える
この論文が扱うのは、特定の連合分類設定におけるバックドア検出です。マルチモーダルに移すには、データセットを差し替えるだけでは足りません。指標タスクをどう定義するか、画像と言語の表現に同様の保持現象があるか、クライアントの誤排除が他の能力に影響するかを、新たに実験する必要があります。
これらは今後の研究課題です。画像分類の実験結果を、マルチモーダルでも既に成立している結論として扱うことはできません。